프로덕션 환경의 태양광 발전량 예측과 이상 탐지
Recs Innovation에 인턴으로 입사했고, 4개월 뒤에는 AI 팀을 이끌고 있었습니다. 팀은 두 가지 모델을 프로덕션에 올렸습니다. 하나는 태양광 발전소가 전력을 얼마나 생산할지 예측하고, 다른 하나는 발전소 데이터에서 평소와 다른 측정값을 찾아냅니다. 두 모델 모두 상용 가상발전소(VPP)에 연동되었습니다. VPP는 여러 발전소를 하나처럼 묶어 운영하는 플랫폼입니다.
- 역할
- Data Science Intern → AI Engineer → AI Team Lead (2024년 3월–11월). ML, 백엔드, 프론트엔드 팀을 이끌었습니다.
- 결과
- 예측 오차는 9%에서 7%로 떨어졌습니다. 이상 탐지 모델의 precision은 35퍼센트포인트(%p), recall은 37%p 올랐습니다. 배포는 3시간 대신 15분이 걸렸습니다.
- 기술 스택
- PyTorch, 그래프 신경망(GNNAD), FastAPI, Docker Compose, GitHub Actions, PostgreSQL, Prometheus, Grafana, MLflow
- 비즈니스 효과
- 예측 모델 덕분에 회사는 한국전력거래소(KPX)의 전력 중개로 수익을 얻을 수 있었습니다. 수동 운영 업무는 80% 줄어 연간 약 48,000달러를 절감했습니다.
문제
회사는 전력 중개 사업에 뛰어들고 있었습니다. 전력 중개란 소규모 태양광 발전소의 전력을 한국전력거래소(KPX)에서 파는 일입니다. 여기에 참여하려면 발전소의 발전량을 충분히 정확하게 예측해야 합니다.
회사는 또한 발전소가 보내는 측정값으로 발전소의 문제를 일찍 알아차려야 했습니다.
그래서 두 가지 모델이 실험이 아니라 프로덕션에서 작동해야 했습니다.
- KPX에 참여할 만큼 정확한, 각 발전소의 발전량 예측 모델
- 발전소 데이터에서 평소와 다른 측정값을 찾아내는 이상 탐지 모델
두 모델 모두 안정적으로 실행되고 상용 VPP 플랫폼에 연동되어야 했습니다.
시스템 개요
- 발전소 데이터 태양광 발전소의 시계열 측정값. 발전소마다 여러 항목을 측정합니다.
- 학습 PyTorch 모델을 학습하고, 실험은 MLflow로 추적합니다. 이상 탐지 모델은 매일 밤 재학습합니다.
- 모델 각 발전소의 발전량 예측 모델과 그래프 기반(GNN) 이상 탐지 모델.
- 추론 API FastAPI 서비스가 예측 결과와 이상 탐지 결과를 제공합니다.
- VPP 플랫폼 서비스는 상용 가상발전소(VPP) 플랫폼에 연동됩니다.
- CI/CDGitHub Actions로 컨테이너 서비스 배포
- 인프라PostgreSQL을 포함한 Docker Compose 서비스
- 모니터링Prometheus 지표와 Grafana 대시보드
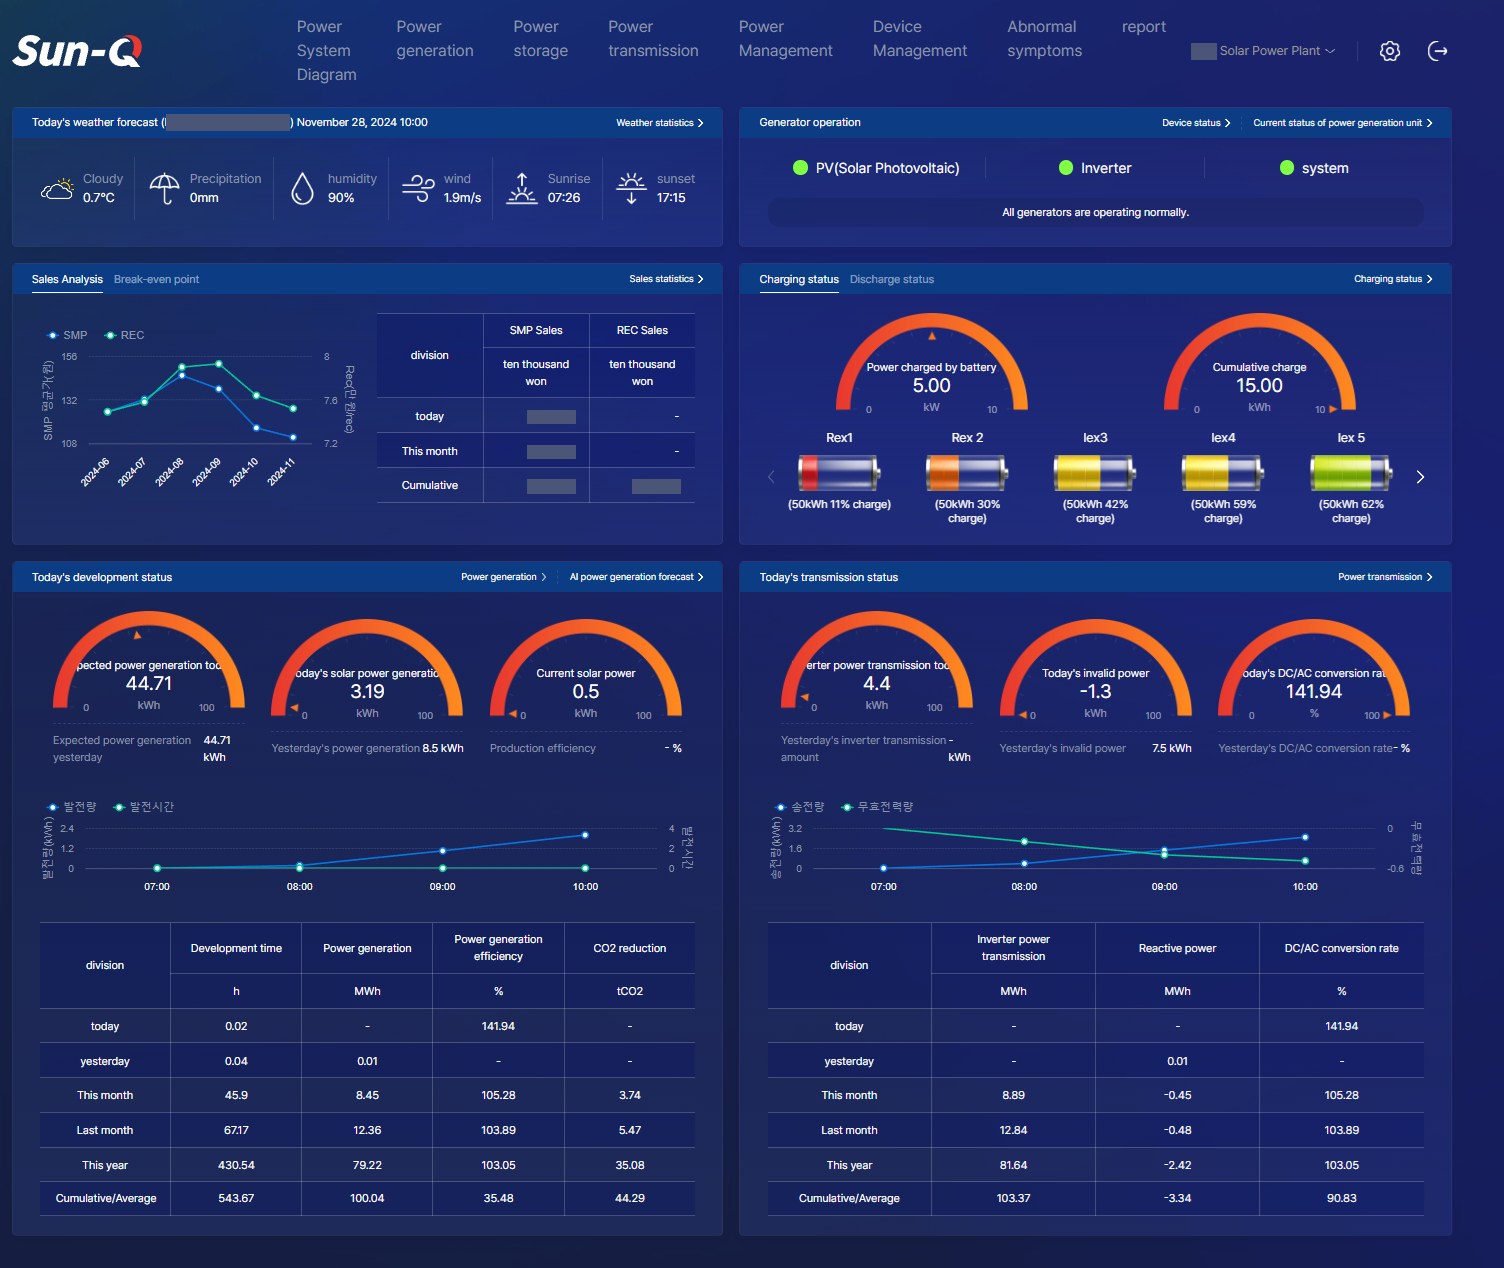
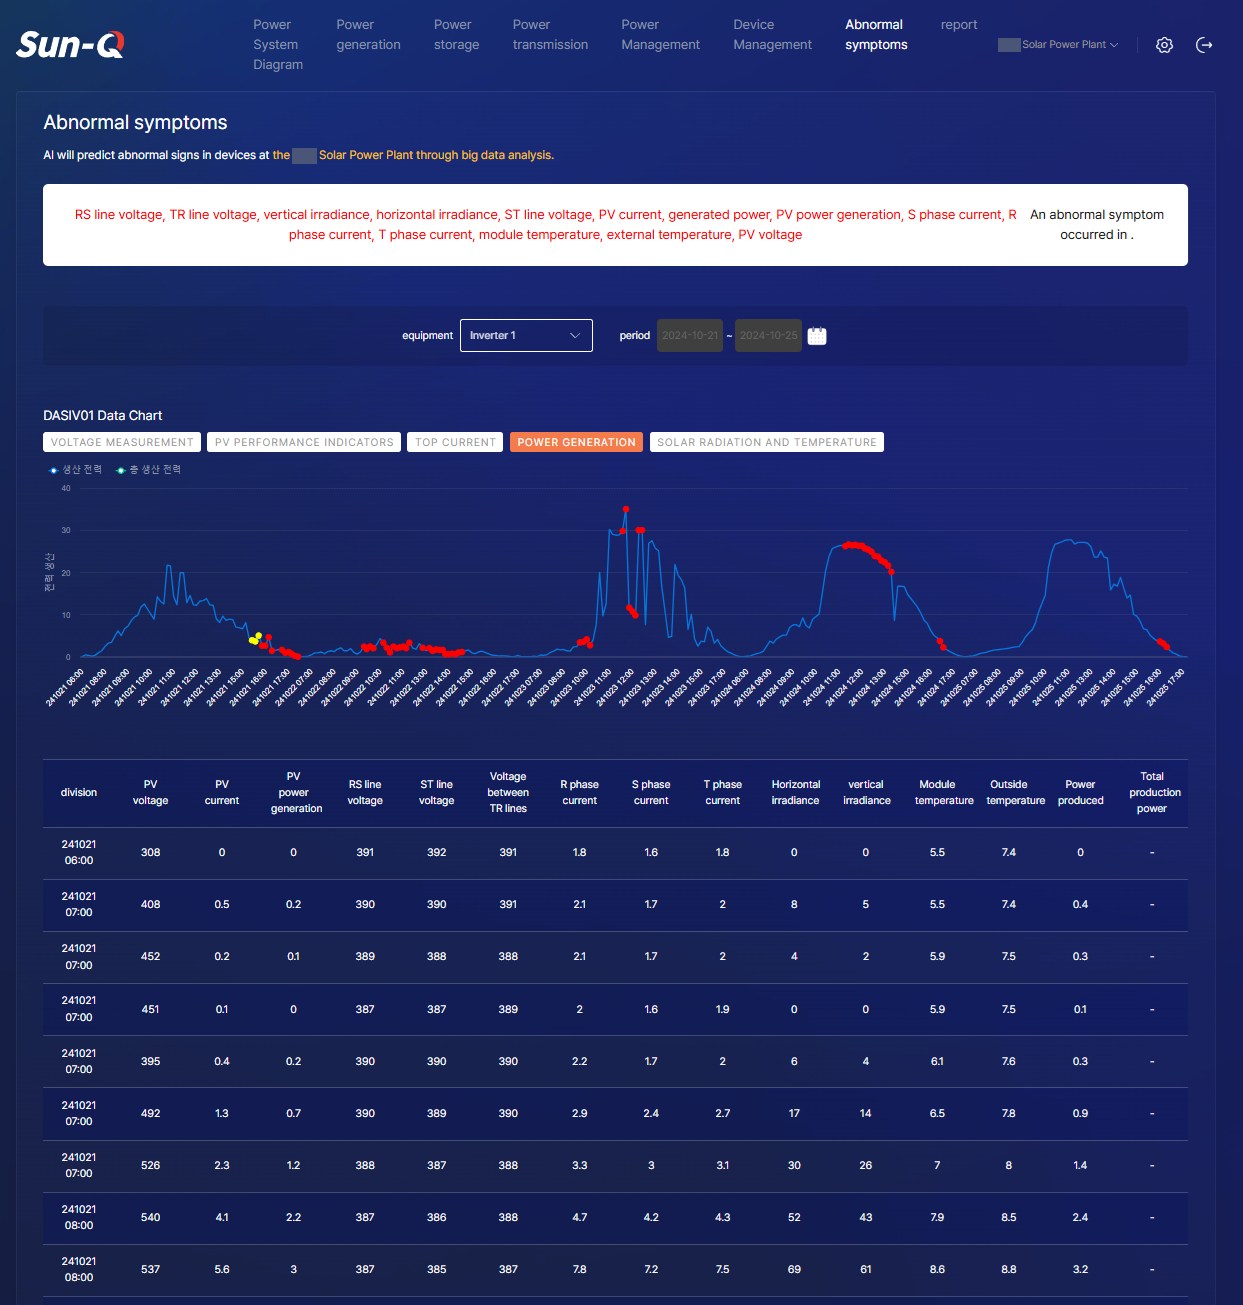
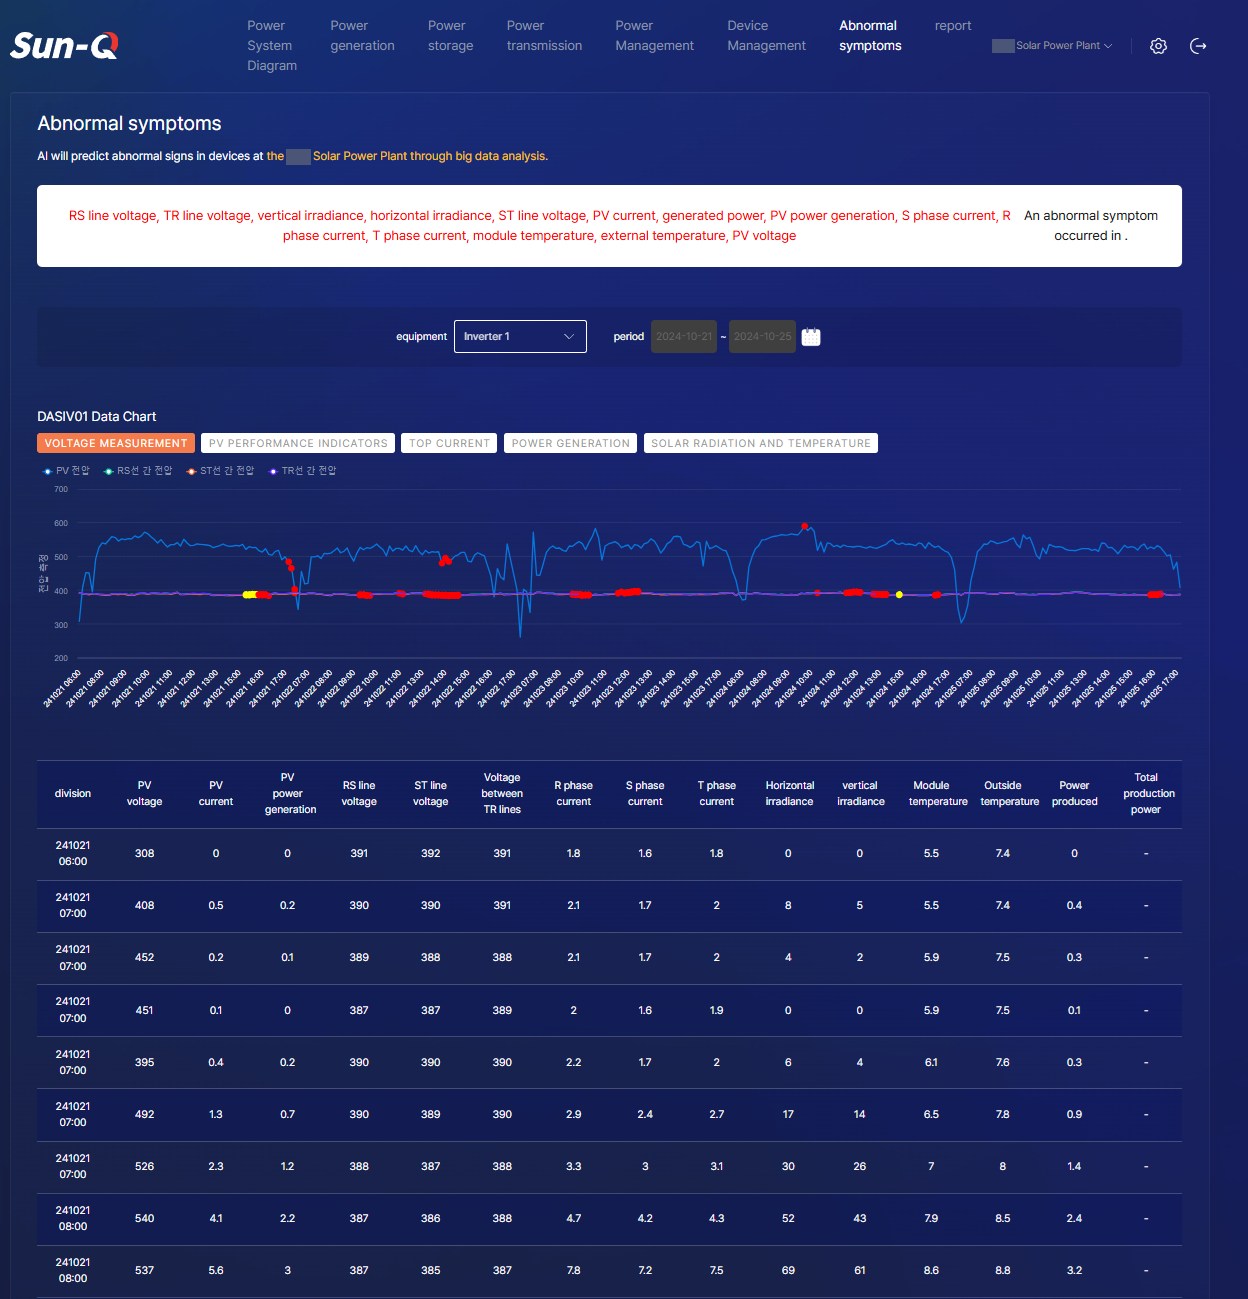
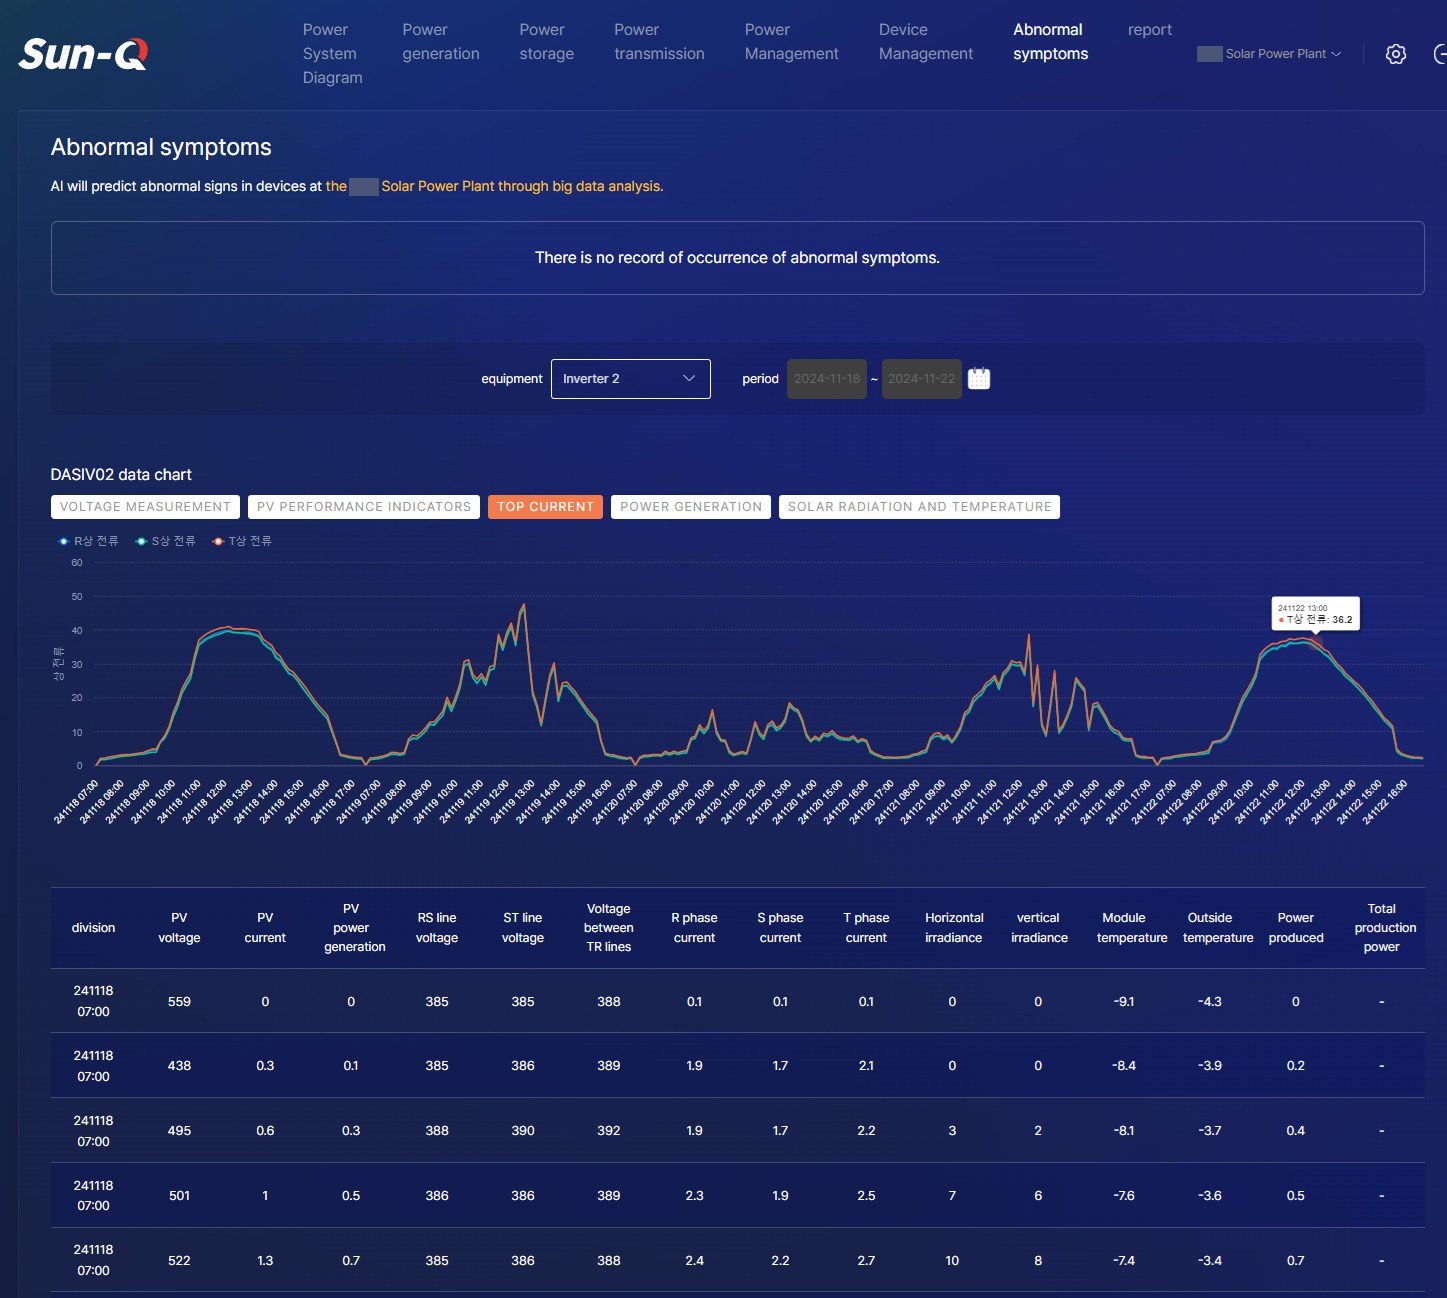
프로덕션 시스템의 스크린샷입니다. 발전소 이름과 위치, 매출 수치는 가렸습니다.
발전량 예측
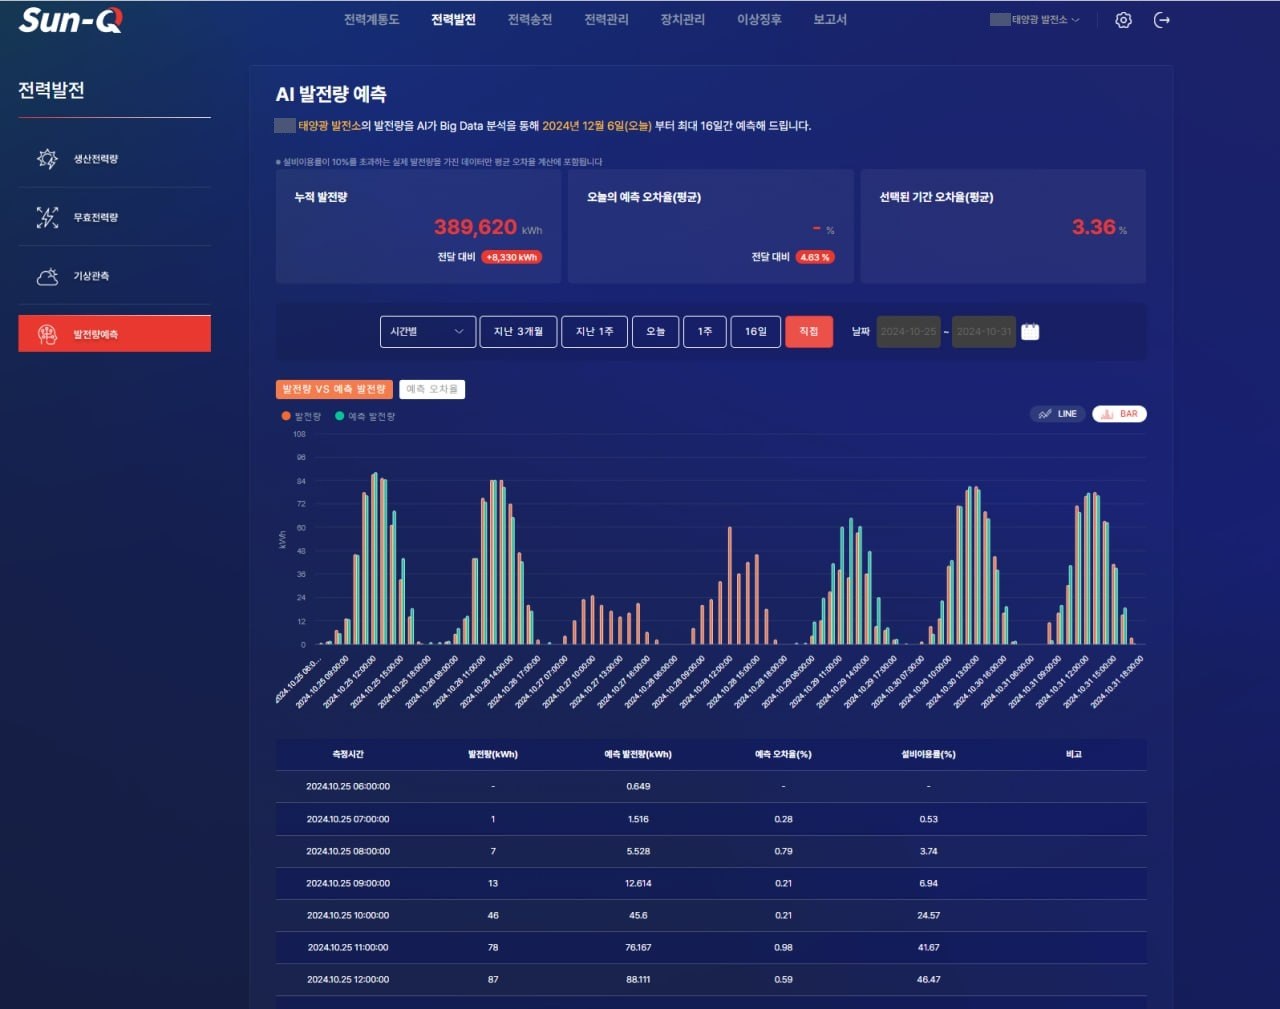
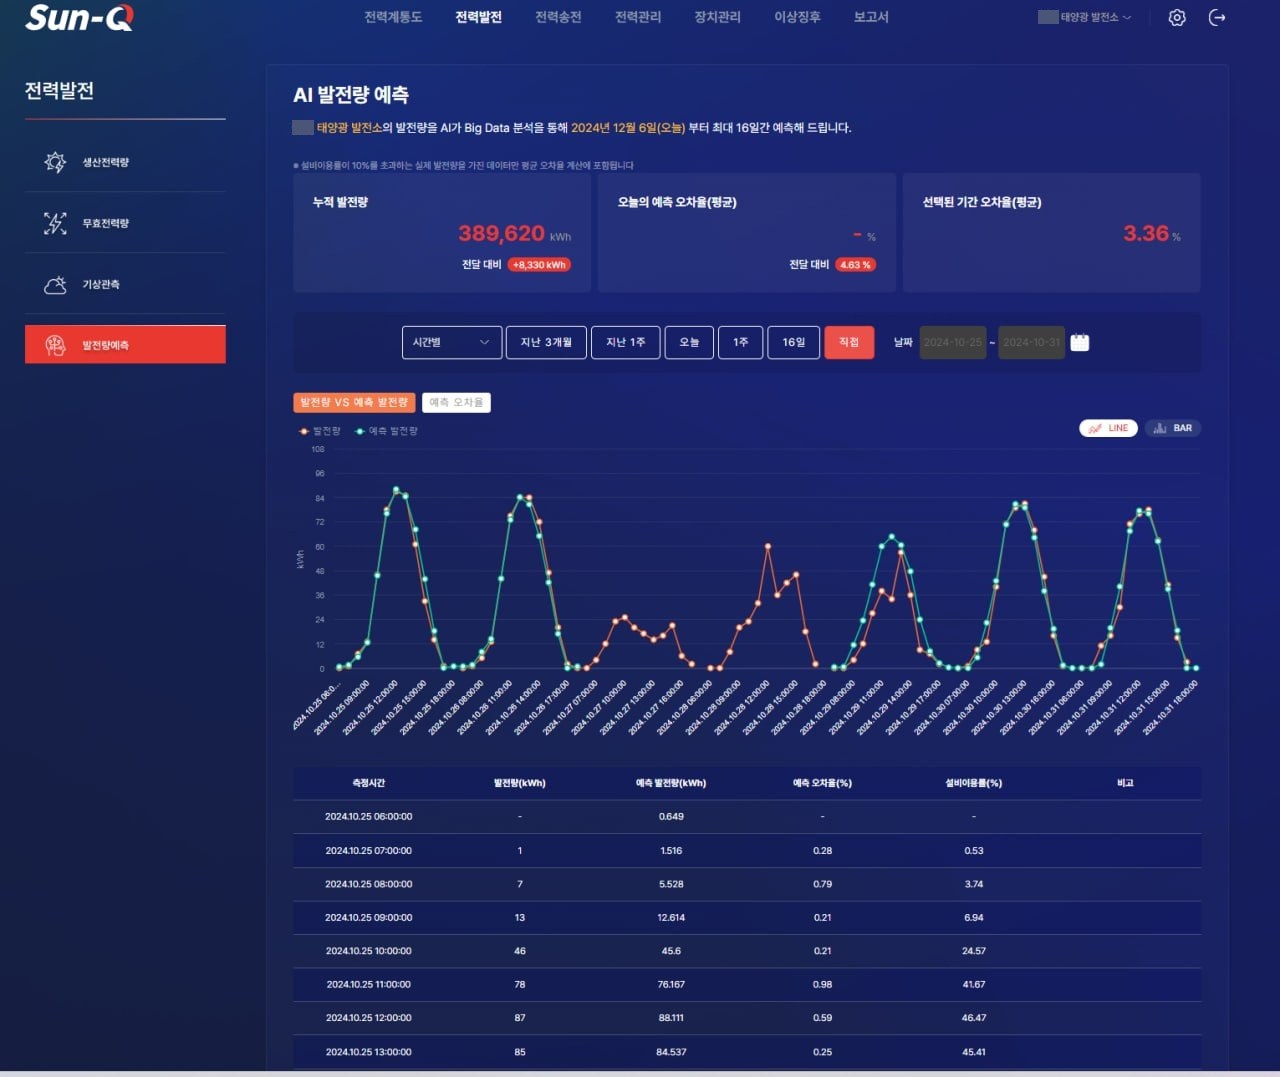
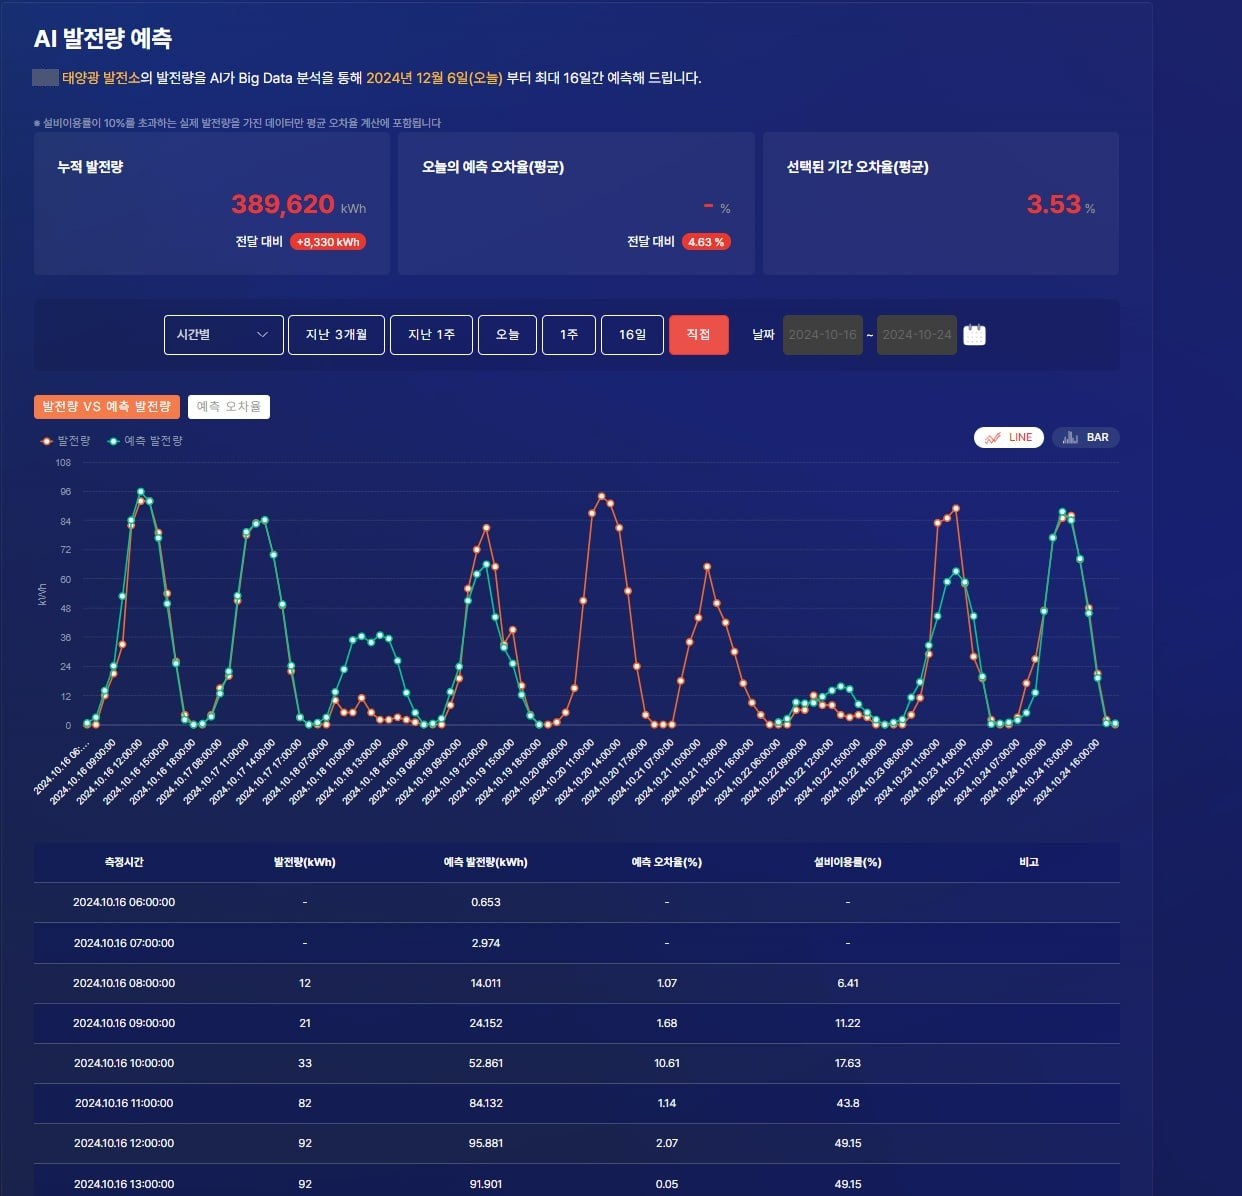
- AI Engineer로서 첫 예측 모델을 PyTorch로 만들었습니다. 평균 오차가 10% 미만이었고, 이 결과로 회사는 KPX 사업 참여 자격을 얻었습니다.
- 팀 리더로서 데이터를 분석하고 모델을 튜닝해 오차를 9%에서 7%로 줄였습니다. 그 덕분에 전력 중개 수익이 가능해졌습니다.
태양광 발전소 이상 탐지
이상 탐지 모델은 그래프 신경망(GNNAD)입니다. 발전소의 측정값들이 평소에 어떻게 함께 움직이는지 학습하고, 그 패턴에서 벗어난 측정값을 찾아냅니다.
인턴 때 이 모델의 첫 버전을 튜닝하고, MLflow로 실험을 추적했으며, 모델을 VPP 플랫폼에 연결하는 FastAPI 엔드포인트를 만들었습니다. 팀 리더가 된 뒤에는 정확도를 단계별로 높이고, 각 단계의 효과를 측정했습니다.
- 오류를 더 명확하게 보기. 오픈소스 코드를 대폭 리팩터링하고, 모든 피처에 대해 예측값과 실제 측정값을 비교하는 그래프를 추가해, 모델이 어디에서 틀리는지 볼 수 있게 했습니다.
- 오차 계산 개선으로 precision이 5%p, recall이 7%p 올랐습니다.
- 시간대별 임계값. 하루 종일 임계값 하나만 쓰면 어떤 시간대의 이상은 놓쳤습니다. 오차가 하루 동안 달라지기 때문입니다. 한 시간에 하나씩 24개의 임계값을 쓰자 recall이 10%p 올랐습니다.
- 더 깨끗한 학습 데이터. 학습 데이터에서 이상값을 제거하자 precision이 30%p, recall이 20%p 올랐습니다.
- 현실적인 검증. 교차 검증을 16포인트 추론 윈도우, 시간대별 임계값, 매일 밤 재학습까지 프로덕션과 같은 방식으로 실행하므로, 테스트 점수가 좋으면 프로덕션 점수도 좋습니다.
전체적으로 precision은 약 35퍼센트포인트, recall은 약 37퍼센트포인트 올랐습니다. 쉽게 말해, 이상 탐지 모델이 잘못된 경보를 훨씬 덜 울리고, 실제 문제를 훨씬 덜 놓치게 되었습니다.
- 오차 계산 개선
- 시간대별 임계값
- 더 깨끗한 학습 데이터
MLOps와 배포
- AI Engineer로서 이상 탐지 모델을 컨테이너에 담고 GitHub Actions로 배포를 자동화했습니다. 배포는 3시간 대신 15분이 걸리게 되었습니다.
- 팀 리더로서 나머지 MLOps 구성을 만들었습니다. PostgreSQL을 포함한 Docker Compose 서비스, GitHub Actions를 통한 배포, Grafana 대시보드에 표시되는 Prometheus 지표입니다. 수동 운영 업무는 80% 줄었고, 연간 약 48,000달러를 절감했습니다.
배포 시간
수동 운영 업무
팀 리딩
AI Team Lead로서 ML, 백엔드, 프론트엔드 팀을 관리했습니다. 제 일은 모델이 실험에 머물지 않게 하는 것이었습니다. 모델은 매일 돌아가야 했고, VPP 플랫폼에 문제없이 연동되어야 했습니다.
결과
- 9% → 7%예측 오차. KPX 전력 중개 수익을 가능하게 했습니다
- +35 / +37%p이상 탐지 모델 precision / recall
- 3시간 → 15분배포 시간
- −80%수동 운영 업무, 연간 약 48,000달러
이 페이지에는 회사 코드, 내부 데이터, 비공개 URL을 싣지 않았습니다.