投入生产的光伏发电预测与异常检测
我以实习生身份加入 Recs Innovation,四个月后开始带领公司的 AI 团队。团队把两个模型投入生产:一个预测光伏电站会发多少电,另一个标记电站数据中的异常读数。两者都接入了一个商业化的虚拟电厂(VPP),即一个把许多电站当作一个整体来运行的平台。
- 我的角色
- Data Science Intern → AI Engineer → AI Team Lead(2024 年 3 月至 11 月)。带领机器学习、后端和前端团队。
- 成果
- 预测误差从 9% 降至 7%。异常检测器的精确率提高了 35 个百分点,召回率提高了 37 个百分点。一次部署从 3 小时缩短至 15 分钟。
- 技术栈
- PyTorch、图神经网络(GNNAD)、FastAPI、Docker Compose、GitHub Actions、PostgreSQL、Prometheus、Grafana、MLflow
- 业务影响
- 预测模型让公司得以通过在 Korea Power Exchange(韩国电力交易所,KPX)的电力中介业务获得收入。人工运维工作减少了 80%,每年约 4.8 万美元。
问题
公司当时正在进入电力中介业务,也就是把小型光伏电站的发电量拿到 Korea Power Exchange(KPX)上出售。要参与这项业务,公司必须足够准确地预测电站的发电量。
公司还需要根据电站发来的读数,尽早发现电站的问题。
因此,两个模型必须在生产环境中运行,而不只是停留在实验阶段:
- 一个预测每座电站发电量的预测模型,准确度要满足 KPX 的要求;以及
- 一个标记电站数据中异常读数的检测器。
两者都必须稳定运行,并接入一个商业化的 VPP 平台。
系统概览
- 电站数据 来自光伏电站的时间序列读数,每座电站有多项测量值。
- 训练 PyTorch 模型,实验记录在 MLflow 中。异常检测器每晚重新训练。
- 模型 每座电站的发电量预测模型和基于图(GNN)的异常检测器。
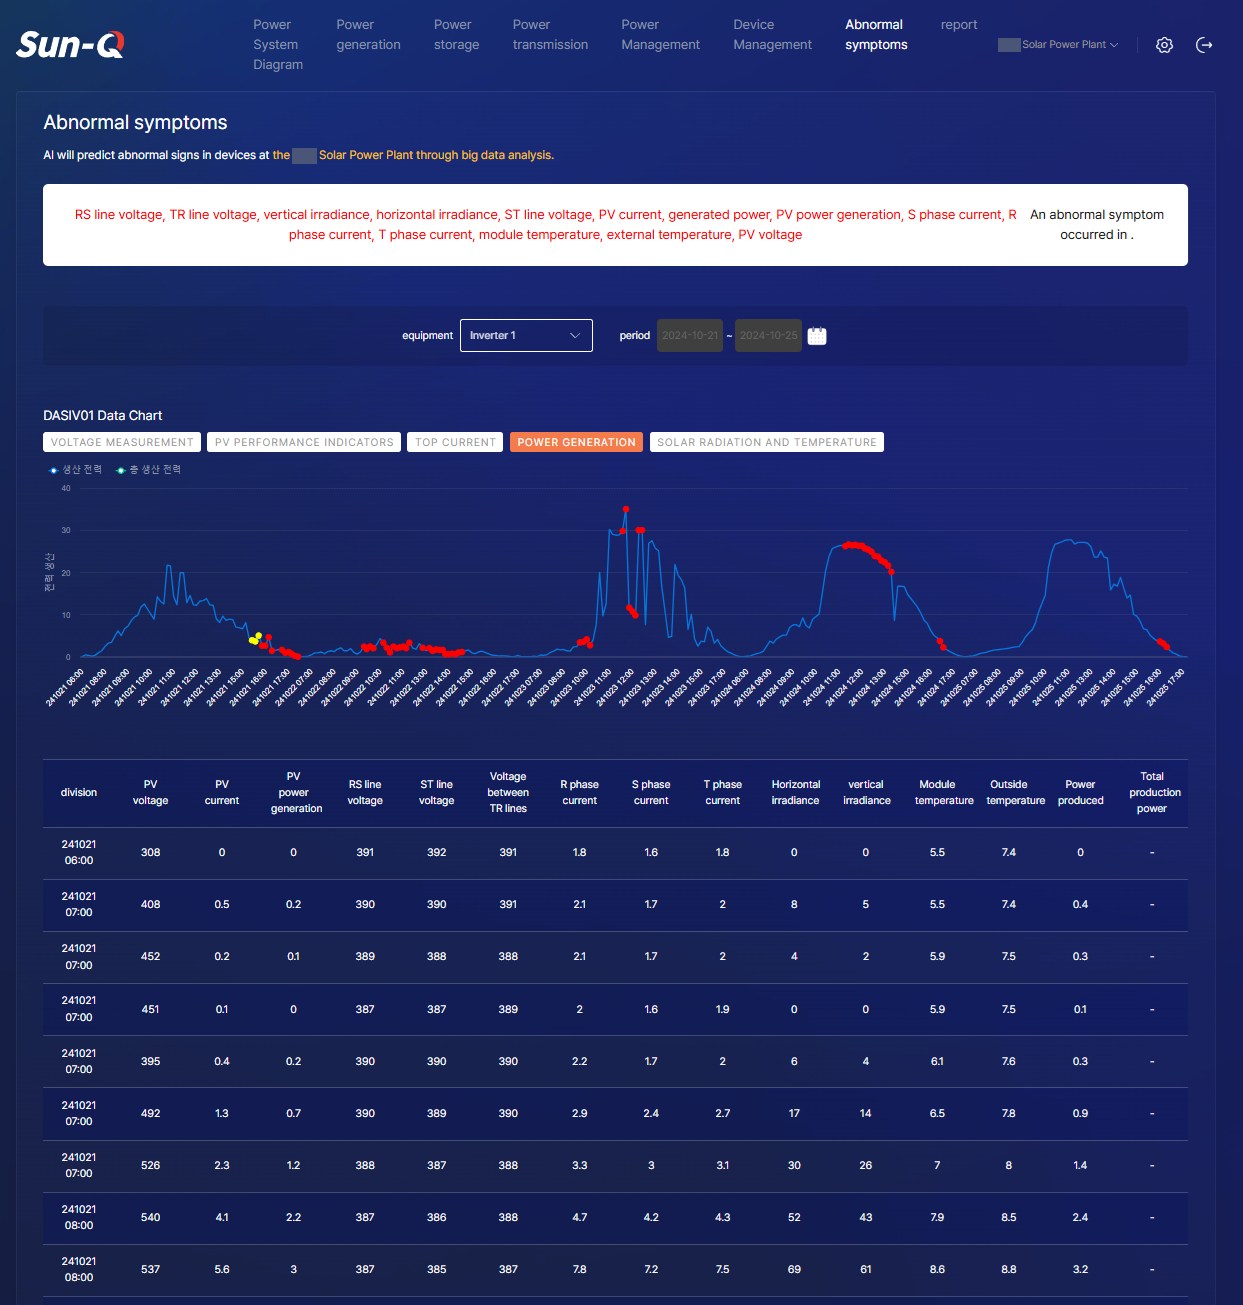
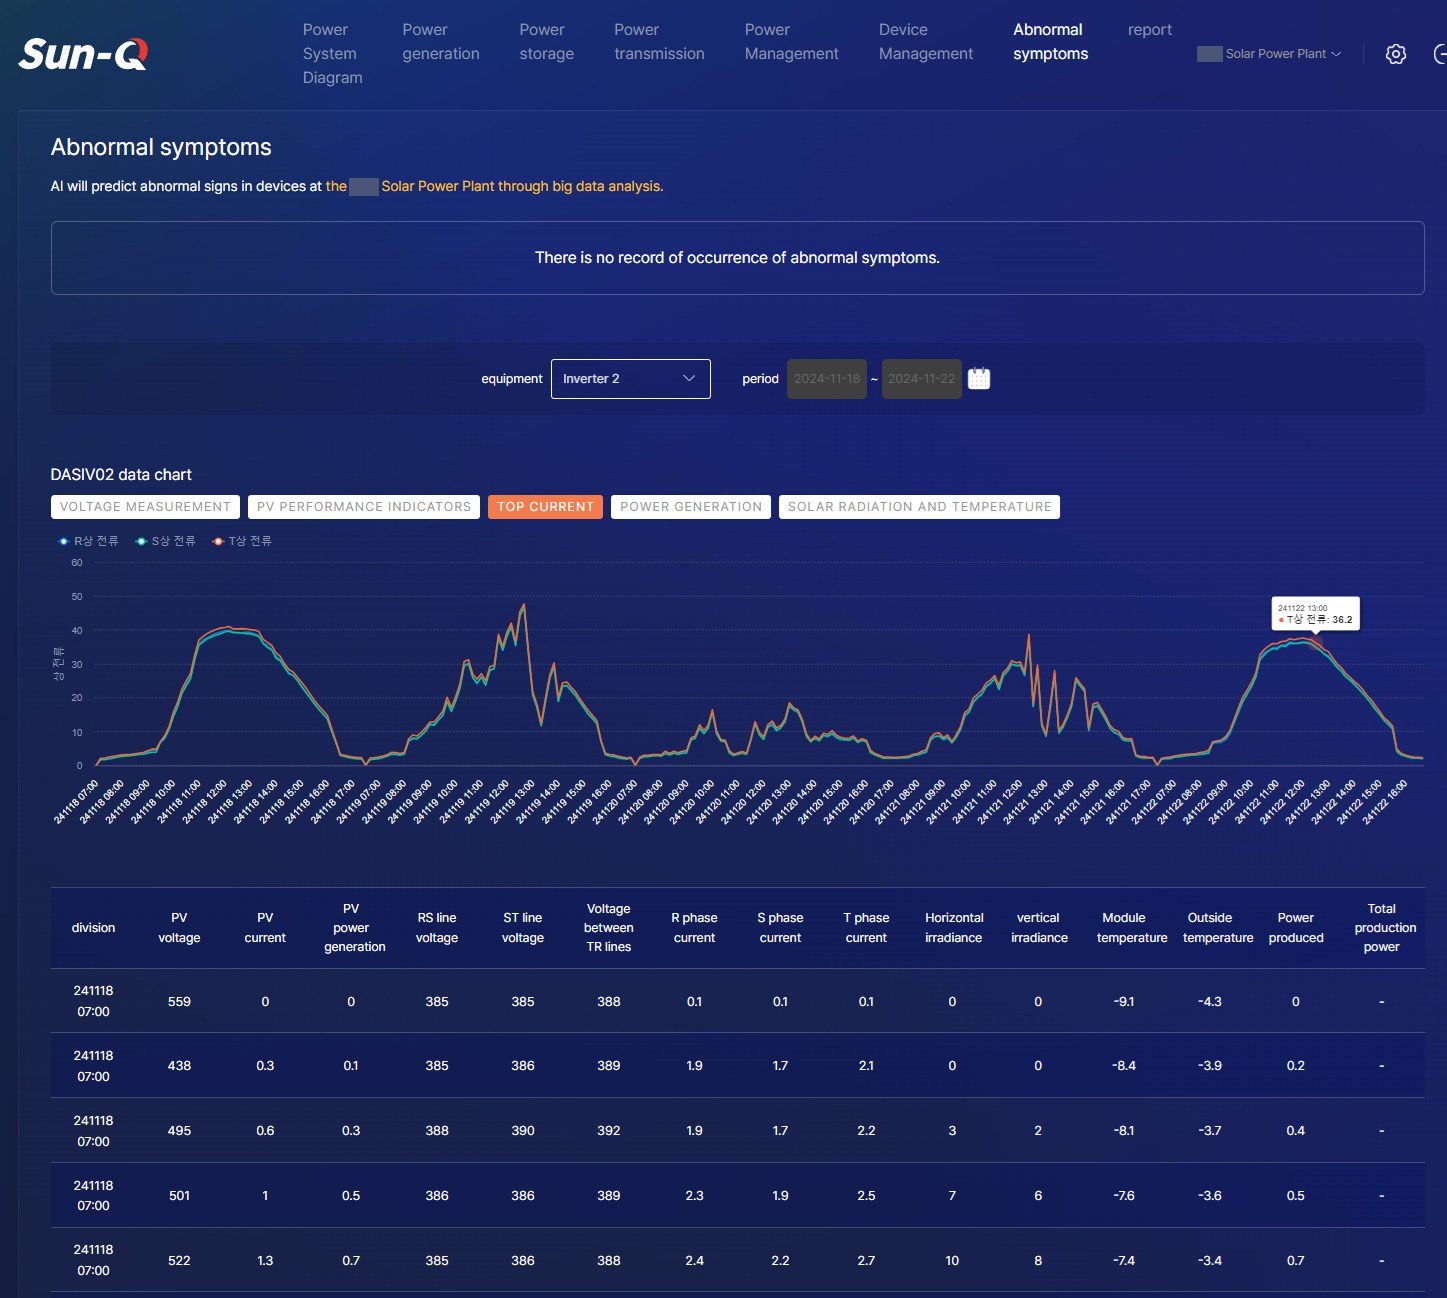
- 推理 API FastAPI 服务提供预测和异常检测结果。
- VPP 平台 这些服务接入一个商业化的虚拟电厂平台。
- CI/CDGitHub Actions 部署容器化服务
- 基础设施Docker Compose 服务与 PostgreSQL
- 监控Prometheus 指标和 Grafana 仪表盘
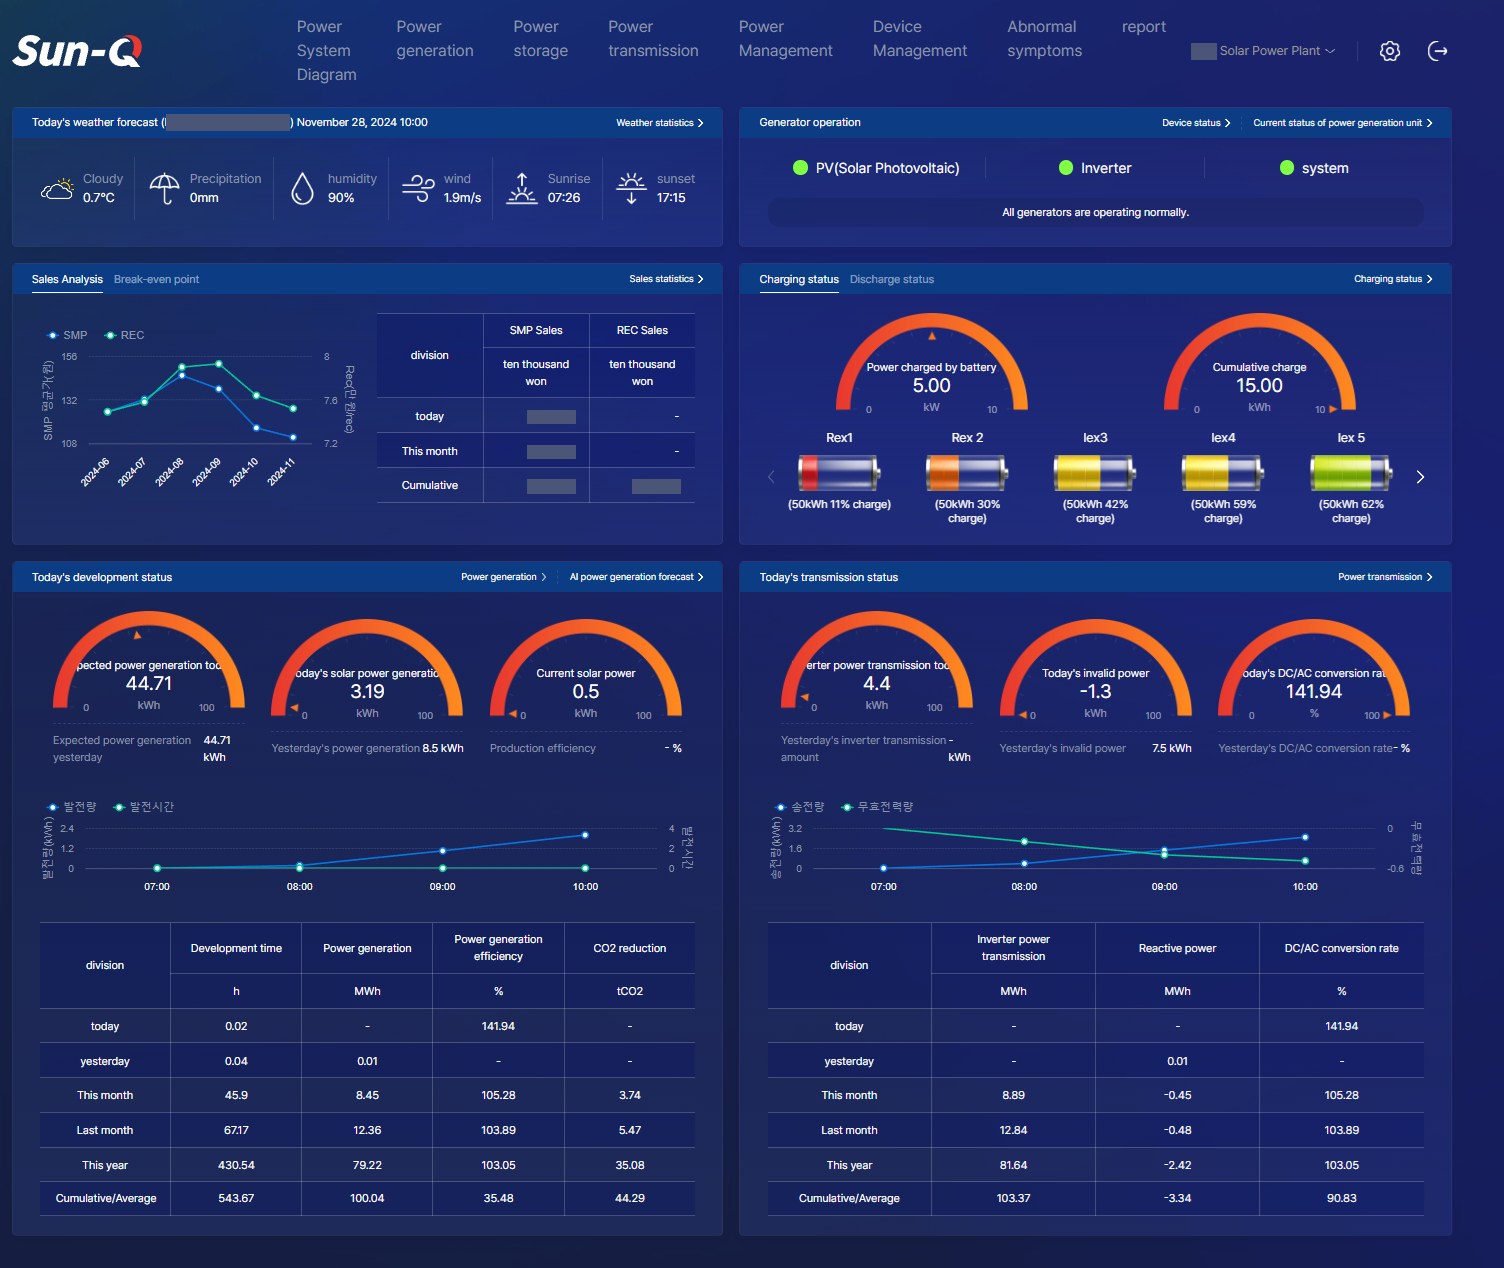
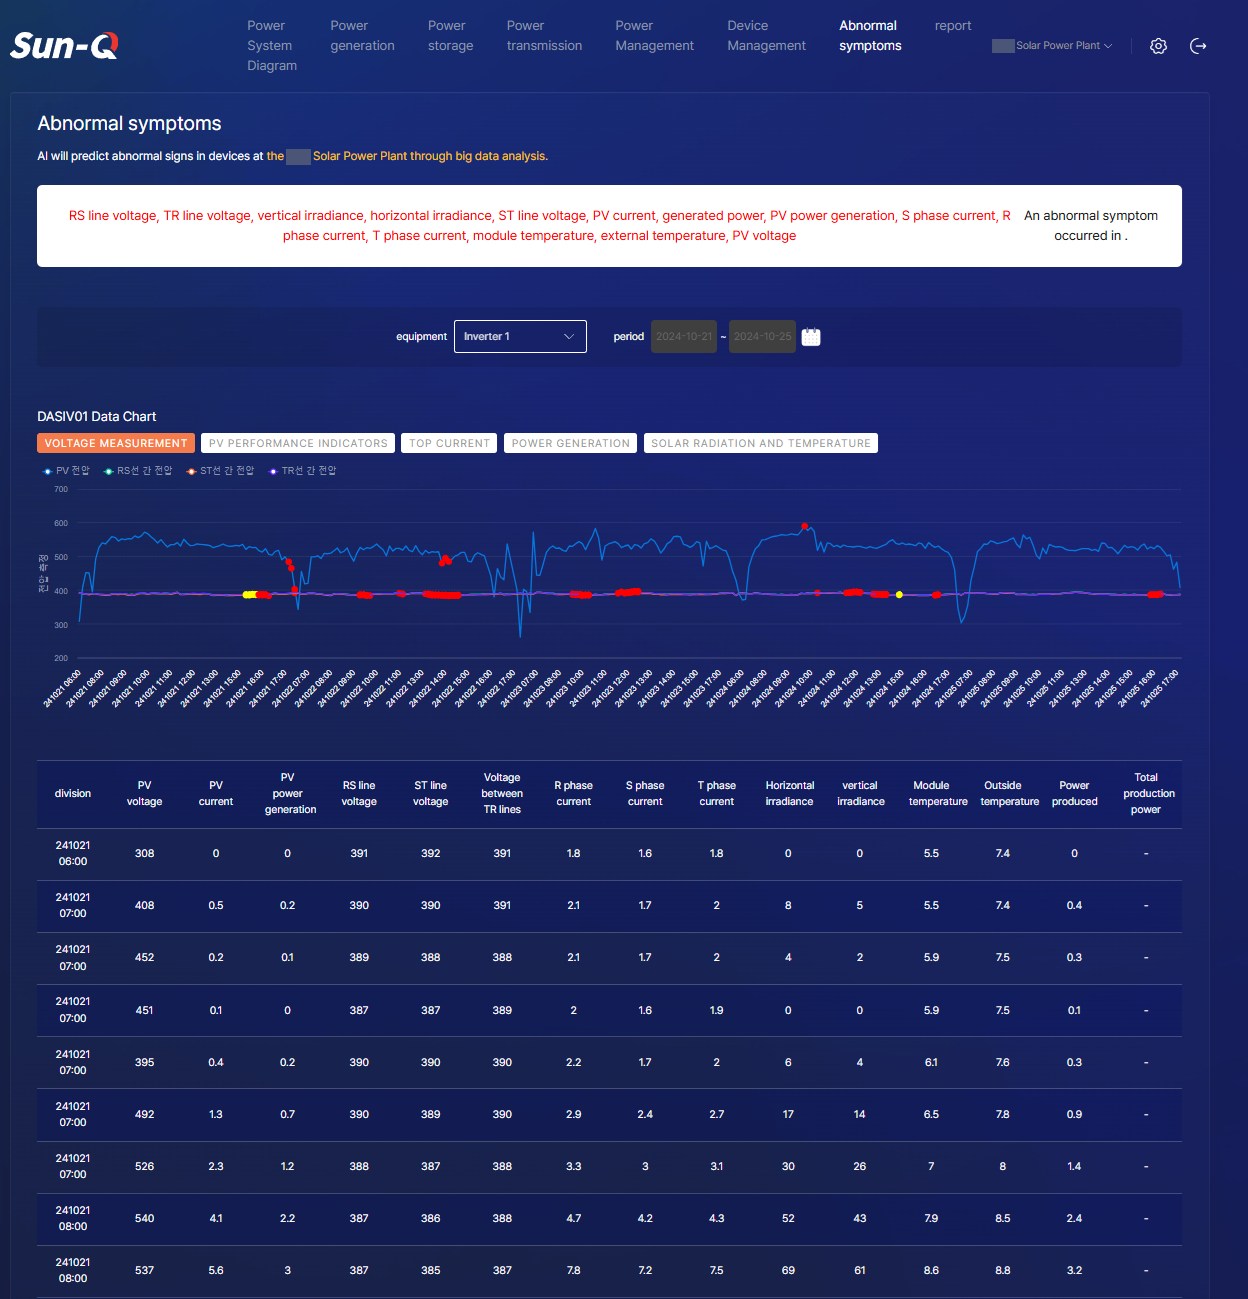
生产系统的截图。电站名称、位置和销售数据已遮盖。
发电预测
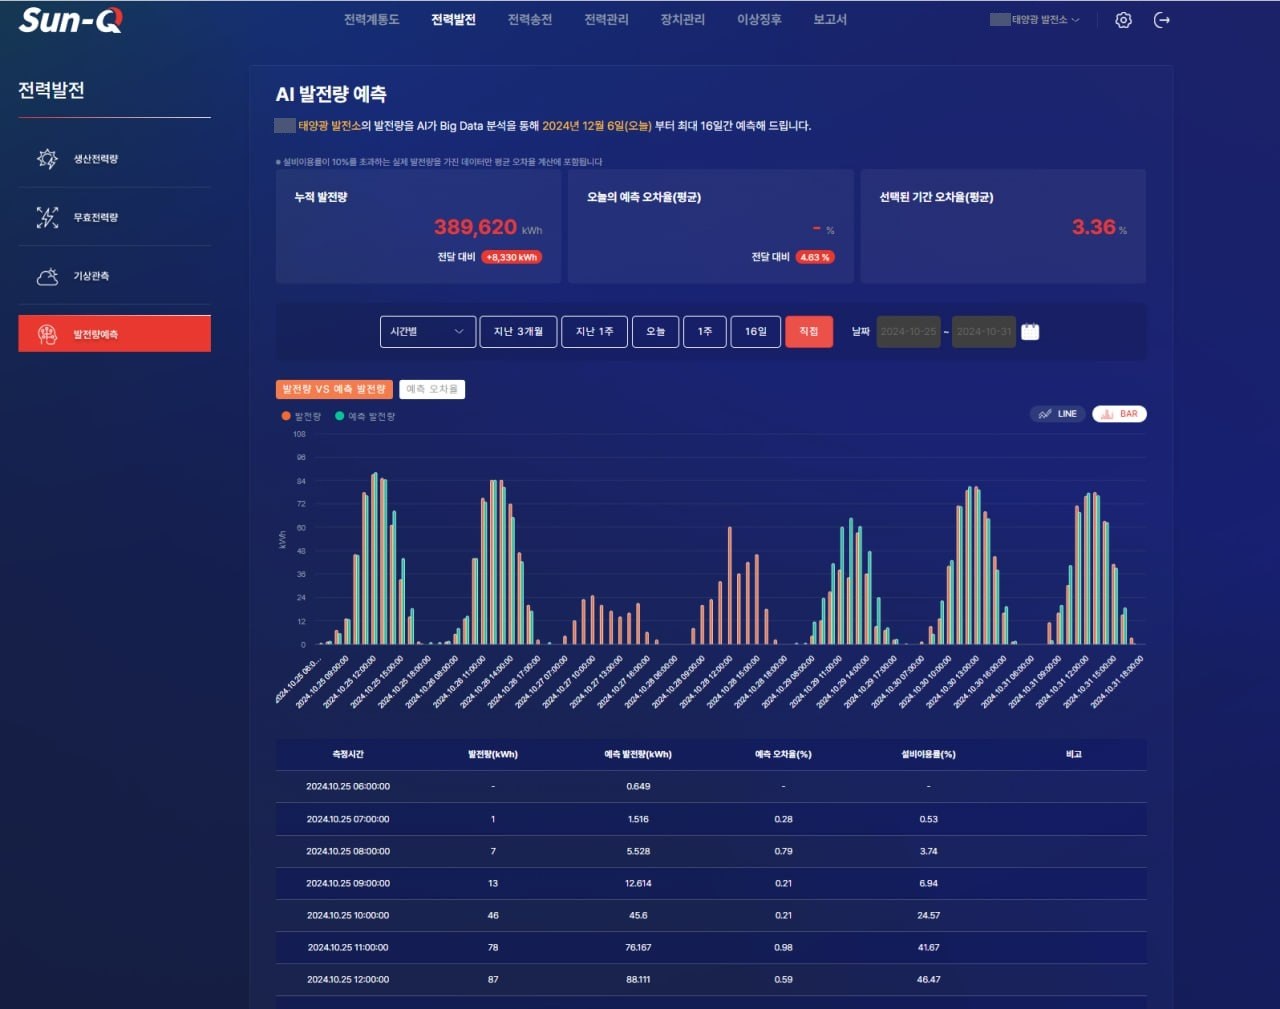
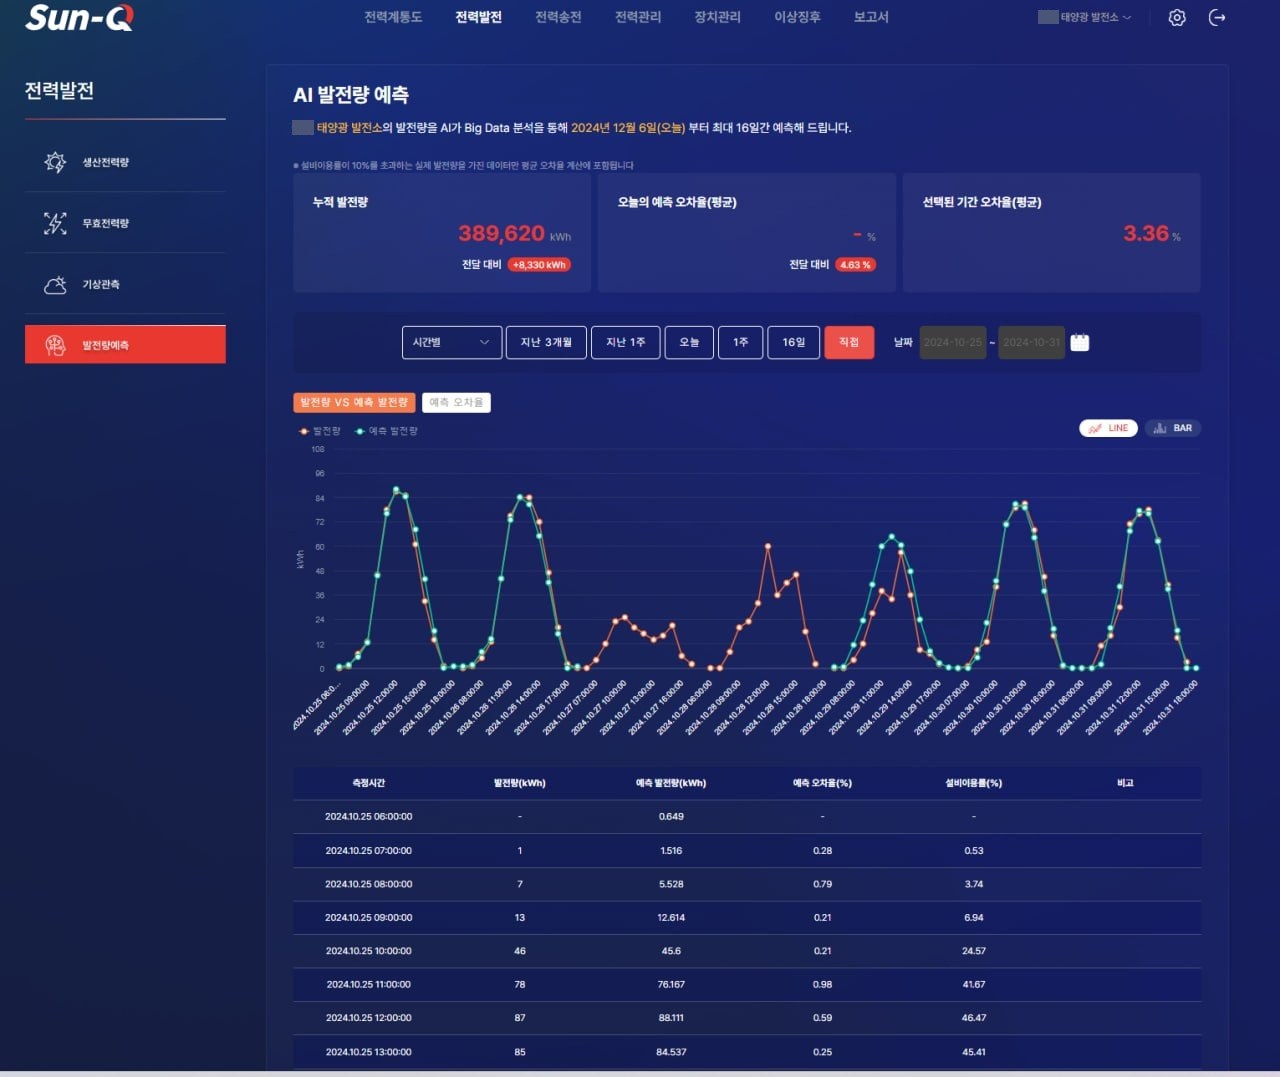
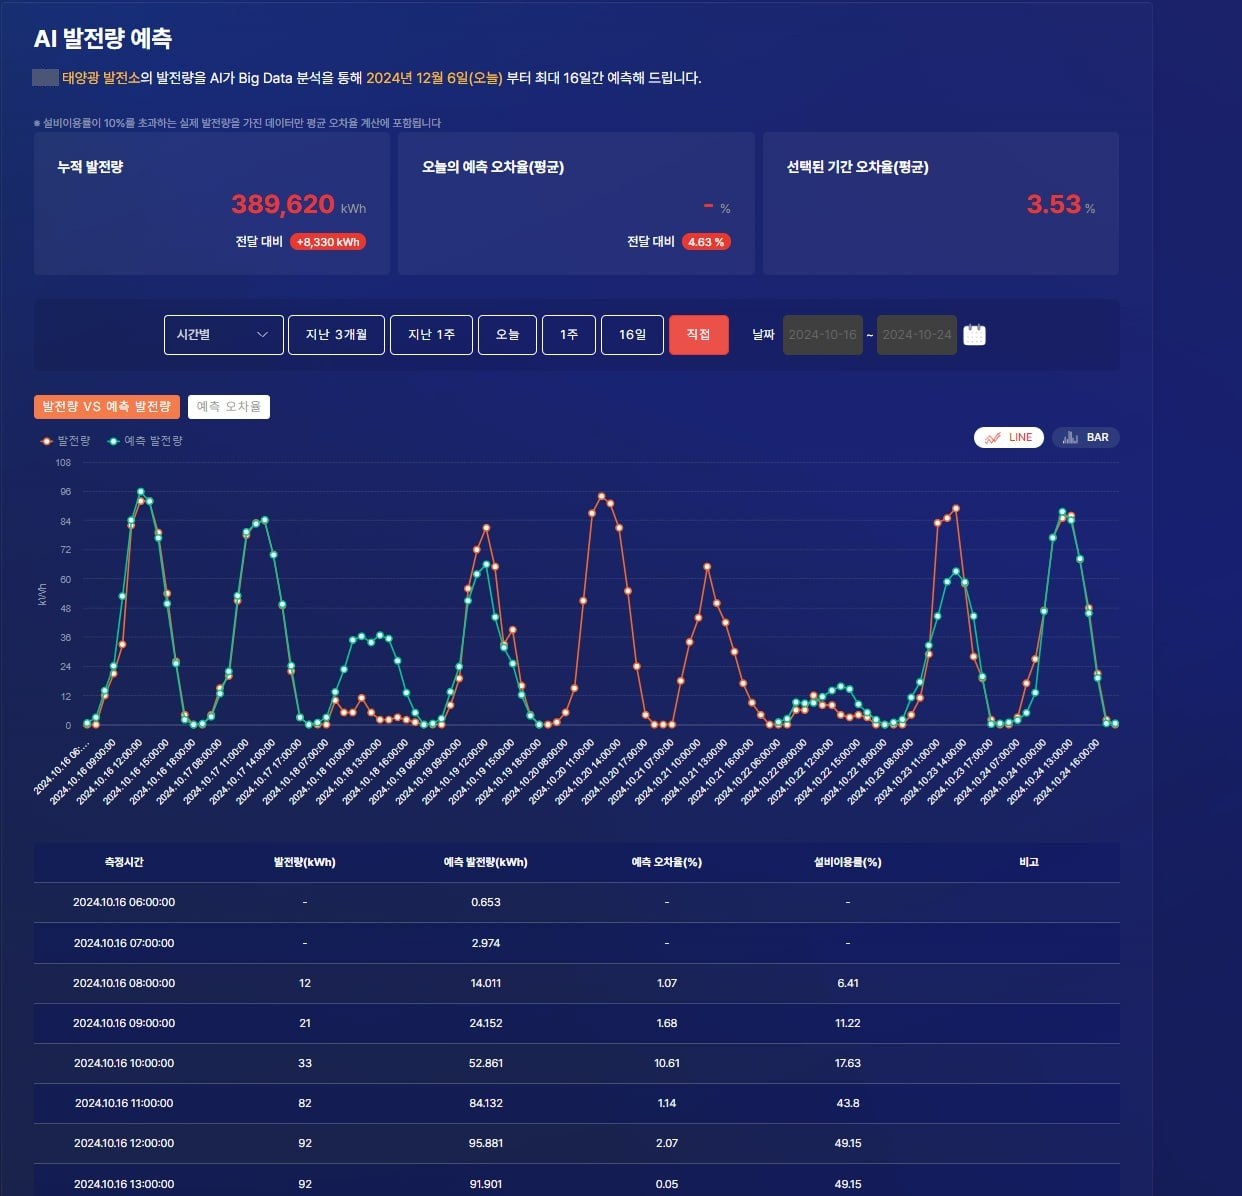
- 作为 AI Engineer,我用 PyTorch 构建了第一个预测模型。它的平均误差低于 10%,这使公司具备了参与 KPX 业务的资格。
- 作为团队负责人,我通过分析数据和调优模型,把误差从 9% 降至 7%。这让电力中介收入成为可能。
光伏电站异常检测
这个异常检测器是一个图神经网络(GNNAD)。它学习电站各项读数在正常情况下如何一起变化,并标记出打破这种模式的读数。
作为实习生,我调优了它的第一个版本,用 MLflow 跟踪实验,并构建了把它接入 VPP 平台的 FastAPI 接口。作为团队负责人,我一步步提高了它的准确率,并衡量了每一步的效果:
- 更清楚地看到误差。我大幅重构了开源代码,并添加了逐个特征对比预测值与实际读数的图表,这样我们就能看到模型错在哪里。
- 更好的误差计算使精确率提高了 5 个百分点,召回率提高了 7 个百分点。
- 按小时设定阈值。全天只用一个阈值时,某些时段的异常会被漏掉,因为误差在一天之内会变化。改用 24 个阈值、每小时一个后,召回率提高了 10 个百分点。
- 更干净的训练数据。从训练集中剔除异常点后,精确率提高了 30 个百分点,召回率提高了 20 个百分点。
- 贴近生产的验证。交叉验证按照生产环境的方式运行,采用 16 个数据点的推理窗口、按小时设定的阈值和每晚重新训练,因此测试成绩好就意味着生产环境中的成绩也好。
总计,精确率提高了约 35 个百分点,召回率提高了约 37 个百分点。用通俗的话说,检测器的误报少了很多,漏掉的真实问题也少了很多。
- 更好的误差计算
- 按小时设定阈值
- 更干净的训练数据
MLOps 与部署
- 作为 AI Engineer,我把异常检测器容器化,并用 GitHub Actions 实现了自动部署。一次部署从 3 小时缩短至 15 分钟。
- 作为团队负责人,我搭建了 MLOps 的其余部分:带 PostgreSQL 的 Docker Compose 服务、通过 GitHub Actions 部署,以及在 Grafana 仪表盘上展示的 Prometheus 指标。人工运维工作减少了 80%,每年节省约 4.8 万美元。
部署时间
人工运维工作
带领团队
作为 AI Team Lead,我管理机器学习、后端和前端团队。我的职责是确保模型不会停留在实验阶段:它们必须每天运行,并顺利接入 VPP 平台。
结果
- 9% → 7%预测误差,让 KPX 电力中介收入成为可能
- +35 / +37 百分点异常检测器精确率 / 召回率
- 3 小时 → 15 分钟部署时间
- −80%人工运维工作,每年约 4.8 万美元
本页面略去了雇主代码、内部数据和私有网址。