Solarprognose und Anomalieerkennung im Produktivbetrieb
Ich habe bei Recs Innovation mit einem Praktikum angefangen und vier Monate später das KI-Team geleitet. Das Team hat zwei Modelle in Produktion gebracht: Eines sagt vorher, wie viel Strom ein Solarkraftwerk erzeugen wird, und eines meldet ungewöhnliche Messwerte in den Daten der Anlage. Beide lieferten ihre Ergebnisse an ein kommerzielles virtuelles Kraftwerk (VPP), eine Plattform, die viele Anlagen gemeinsam wie eine einzige betreibt.
- Meine Rolle
- Data Science Intern → AI Engineer → AI Team Lead (März–Nov. 2024). Leitung der ML-, Backend- und Frontend-Teams.
- Ergebnis
- Der Prognosefehler sank von 9 % auf 7 %. Die Precision der Anomalieerkennung stieg um 35 Prozentpunkte, der Recall um 37. Ein Deployment dauerte 15 Minuten statt 3 Stunden.
- Stack
- PyTorch, Graph Neural Network (GNNAD), FastAPI, Docker Compose, GitHub Actions, PostgreSQL, Prometheus, Grafana, MLflow
- Geschäftlicher Nutzen
- Die Prognose ermöglichte dem Unternehmen Einnahmen aus der Stromvermittlung an der Korea Power Exchange (KPX). Der manuelle Betriebsaufwand sank um 80 %, rund 48.000 $ pro Jahr.
Das Problem
Das Unternehmen stieg in die Stromvermittlung ein, das heißt in den Verkauf des Stroms kleiner Solarkraftwerke an der Korea Power Exchange (KPX), der koreanischen Strombörse. Um daran teilzunehmen, muss ein Unternehmen die Erzeugung der Anlagen genau genug vorhersagen.
Das Unternehmen musste außerdem Probleme an einer Anlage früh bemerken, anhand der Messwerte, die die Anlage sendet.
Also mussten zwei Modelle in Produktion funktionieren, nicht nur im Experiment:
- eine Prognose der Erzeugung jeder Anlage, genau genug für die KPX, und
- ein Detektor, der ungewöhnliche Messwerte in den Daten einer Anlage meldet.
Beide mussten zuverlässig laufen und sich in eine kommerzielle VPP-Plattform einfügen.
Systemüberblick
- Anlagendaten Zeitreihen von Messwerten aus Solarkraftwerken, viele Messgrößen pro Anlage.
- Training PyTorch-Modelle, Experimente in MLflow nachverfolgt. Der Anomaliedetektor wird jede Nacht neu trainiert.
- Modelle Eine Prognose der Erzeugung jeder Anlage und ein graphbasierter Anomaliedetektor (GNN).
- Inferenz-APIs FastAPI-Dienste stellen die Prognosen und die Ergebnisse der Anomalieerkennung bereit.
- VPP-Plattform Die Dienste sind an eine kommerzielle Plattform für virtuelle Kraftwerke angebunden.
- CI/CDGitHub Actions deployt containerisierte Dienste
- InfrastrukturDocker-Compose-Dienste mit PostgreSQL
- MonitoringPrometheus-Metriken und Grafana-Dashboards
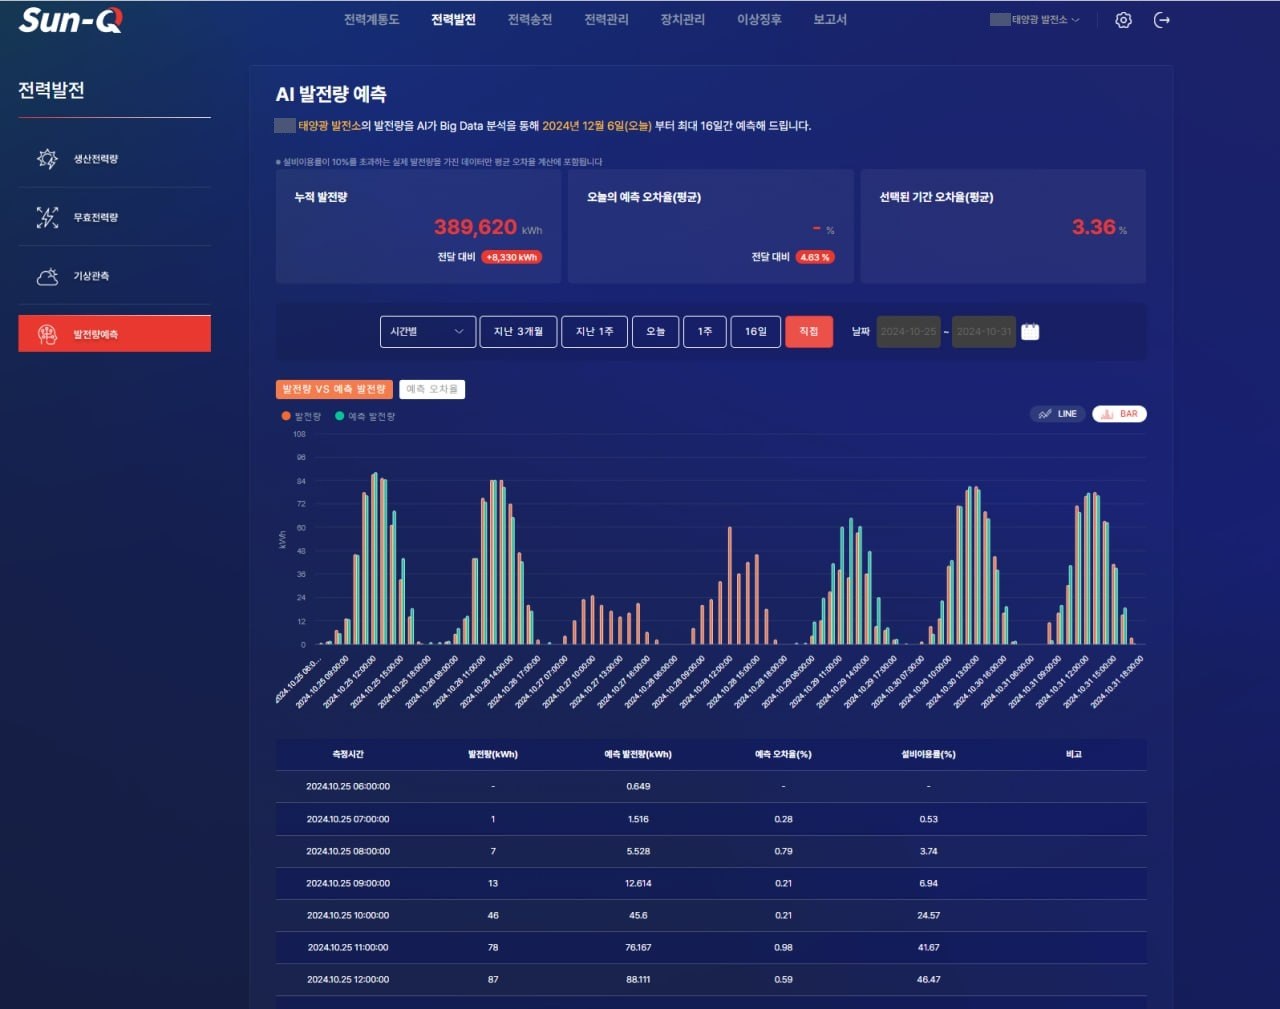
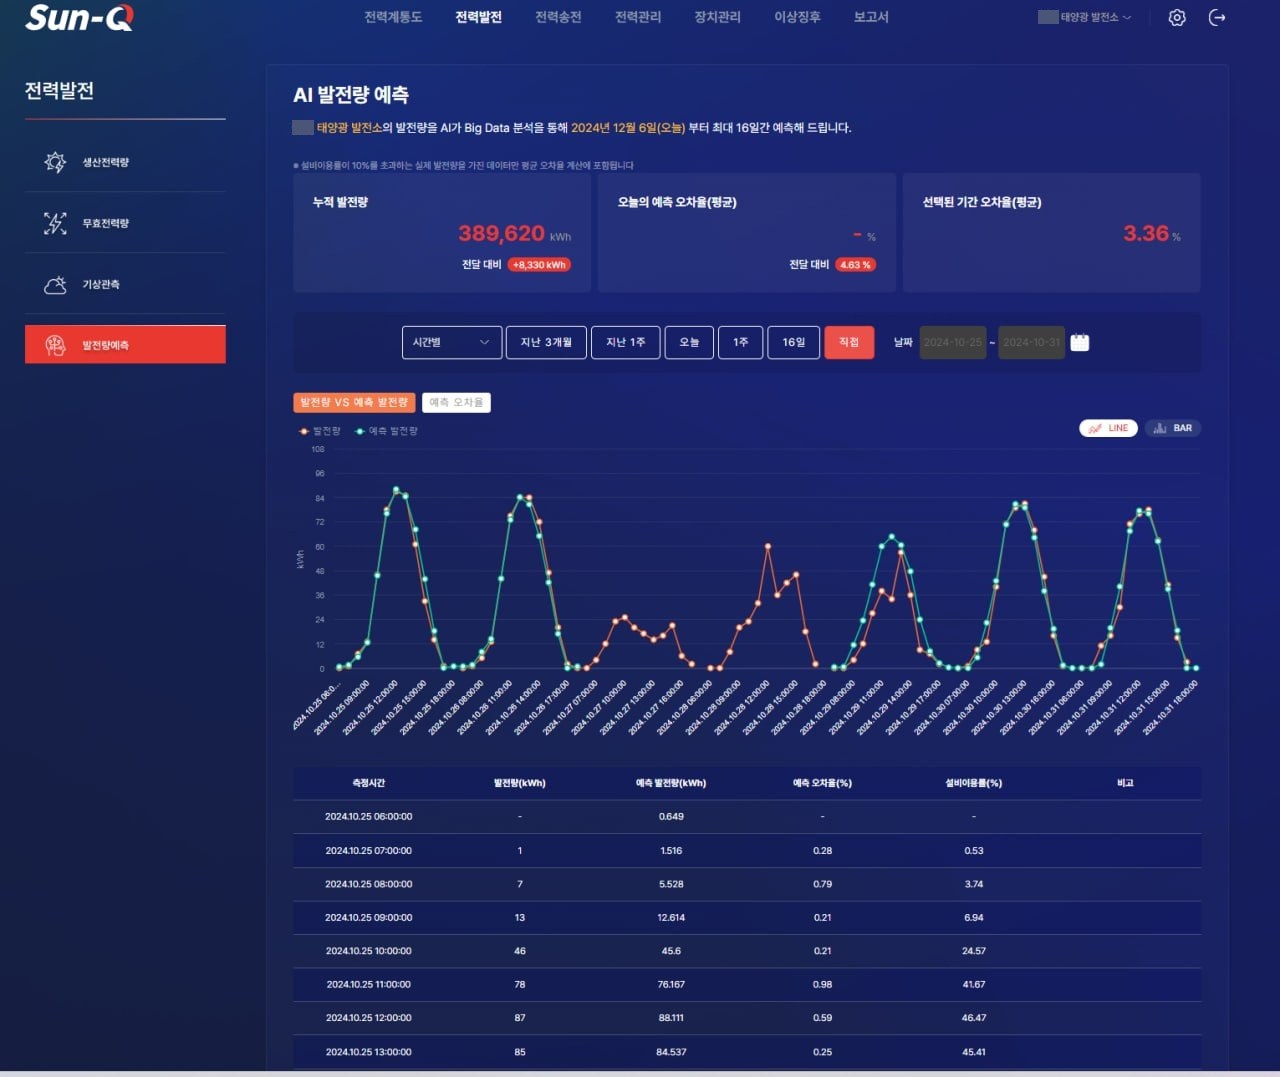
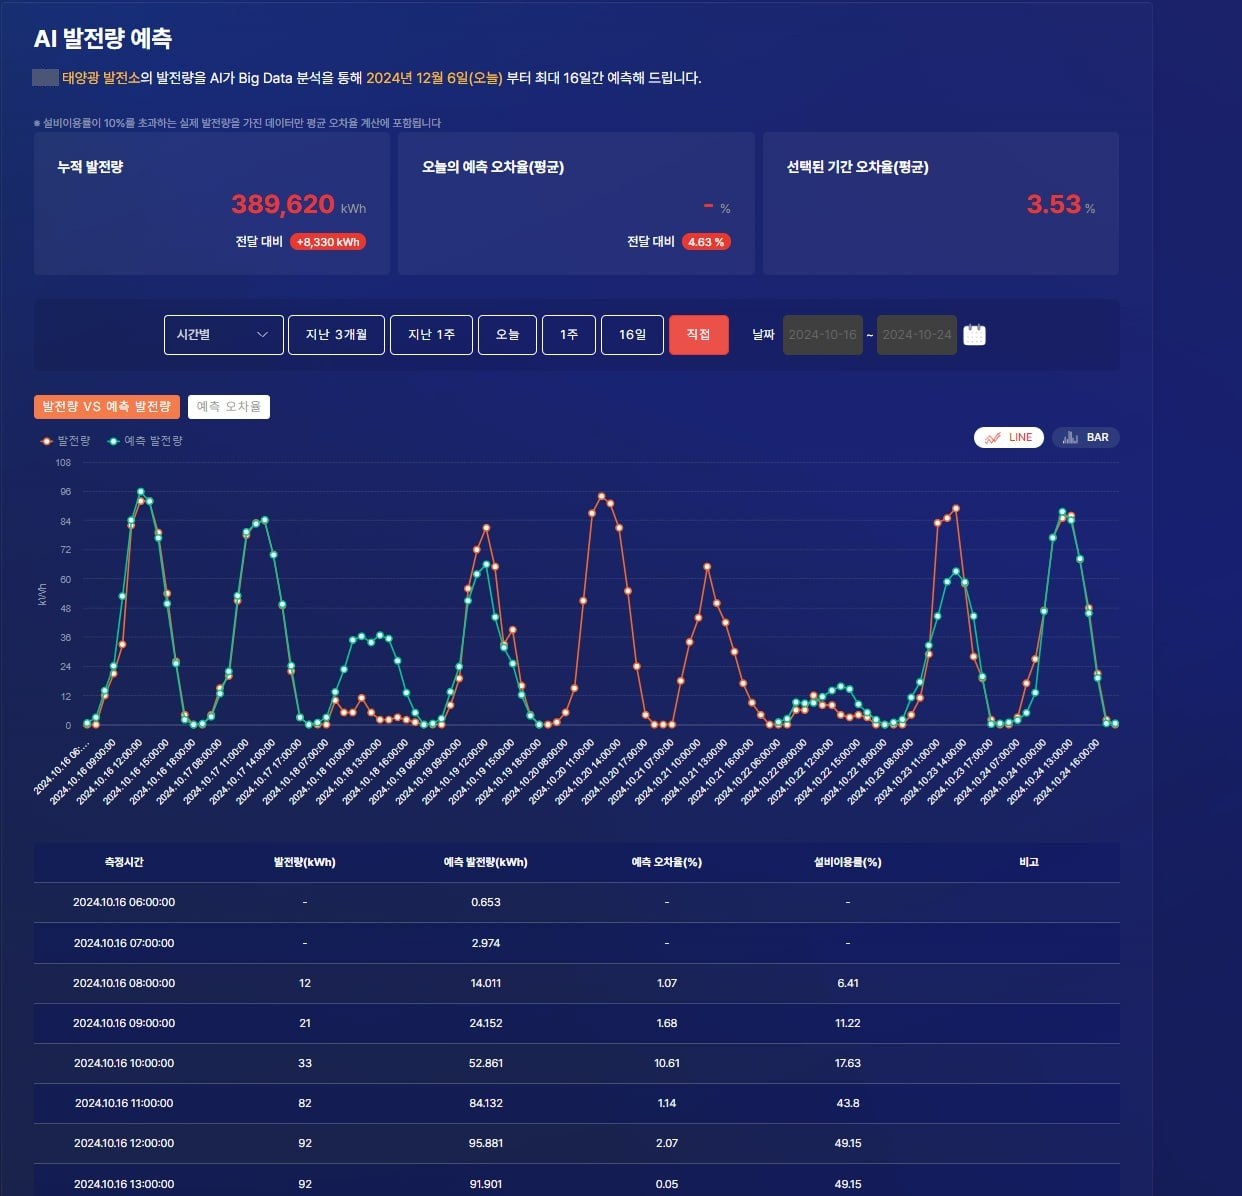
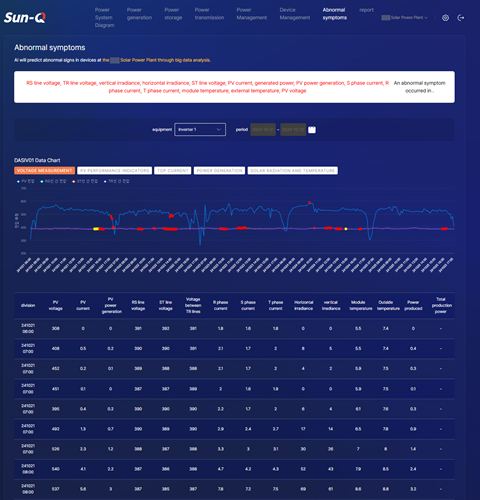
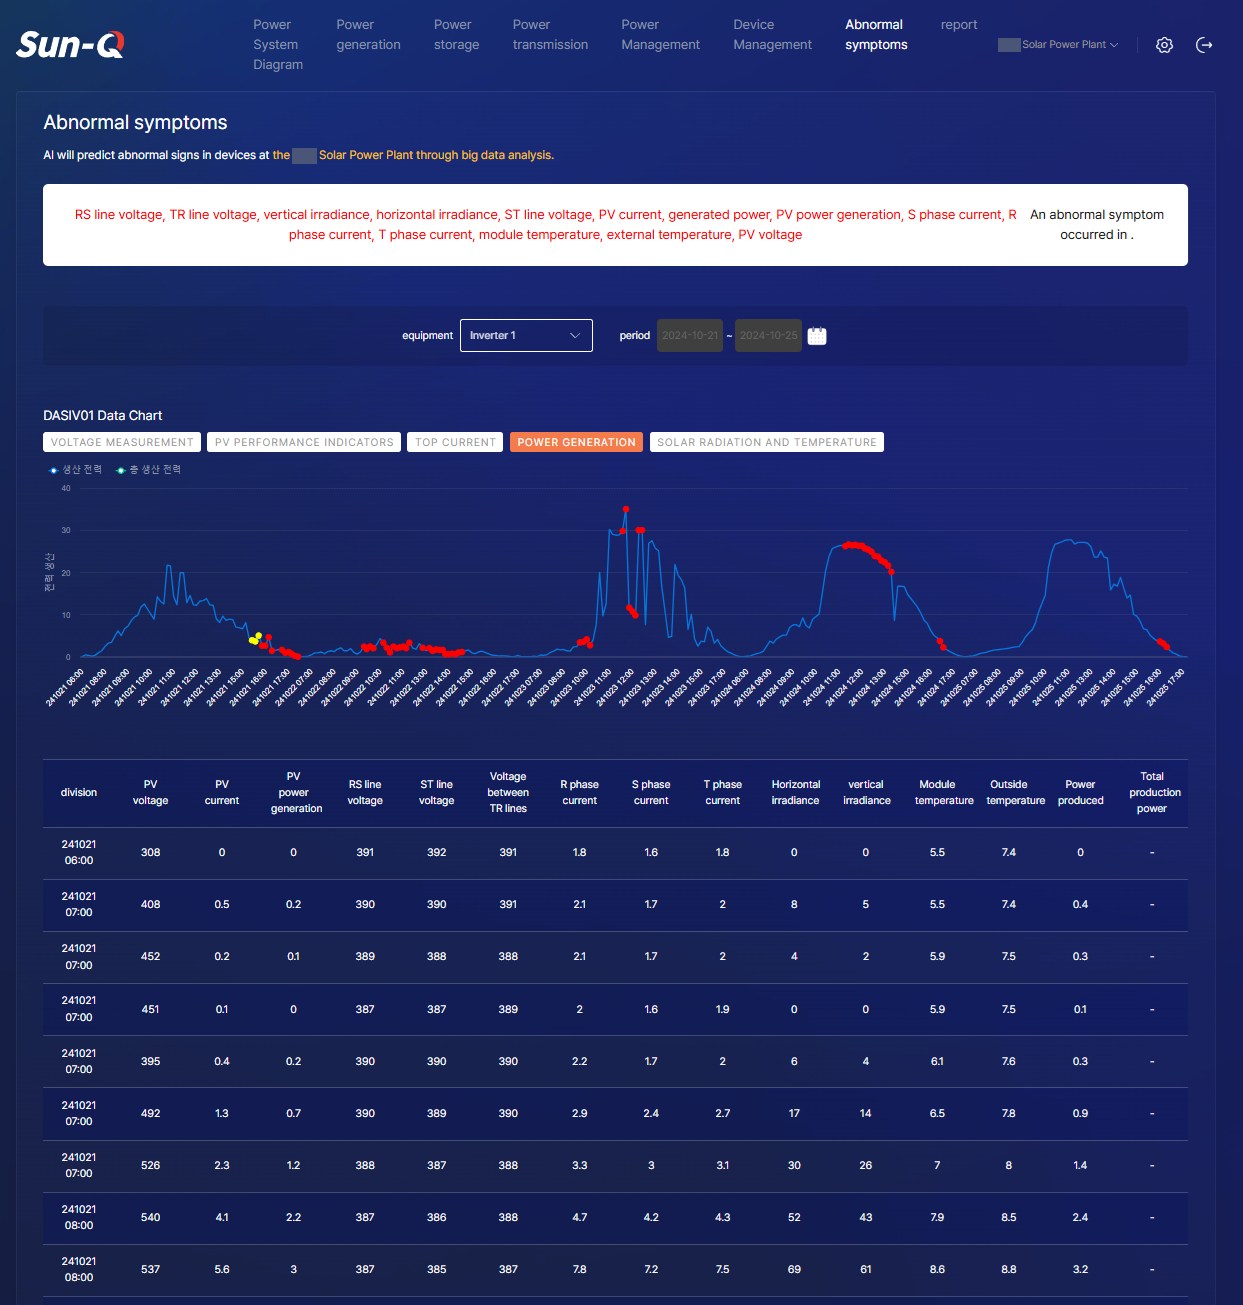
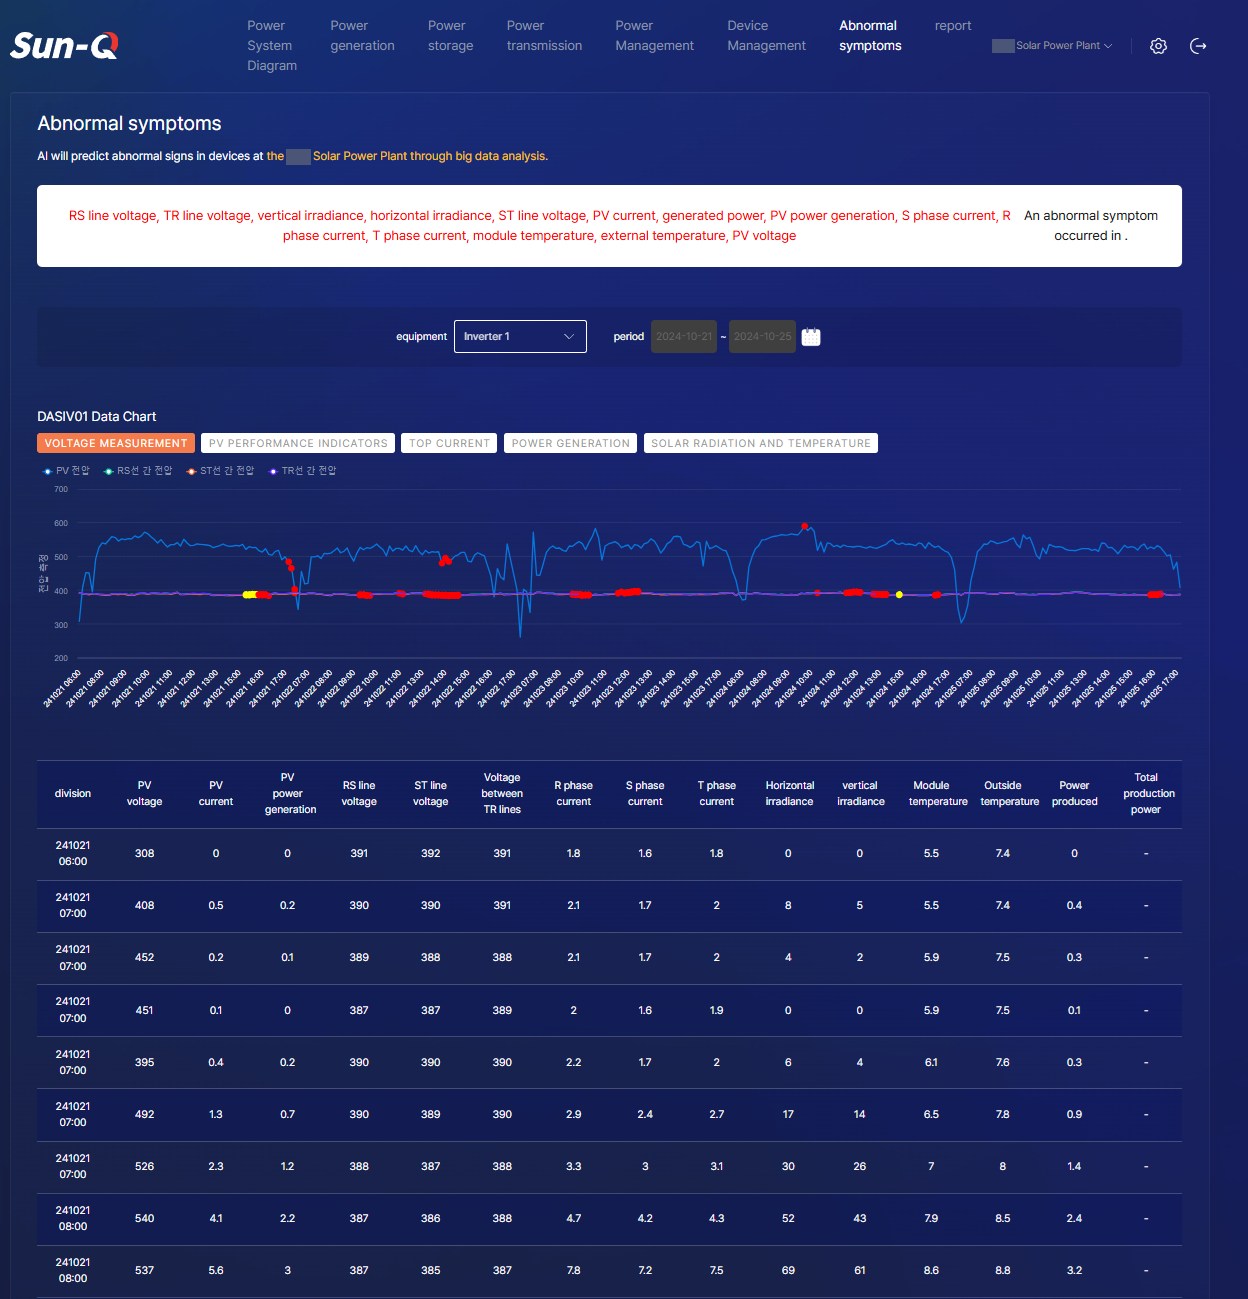
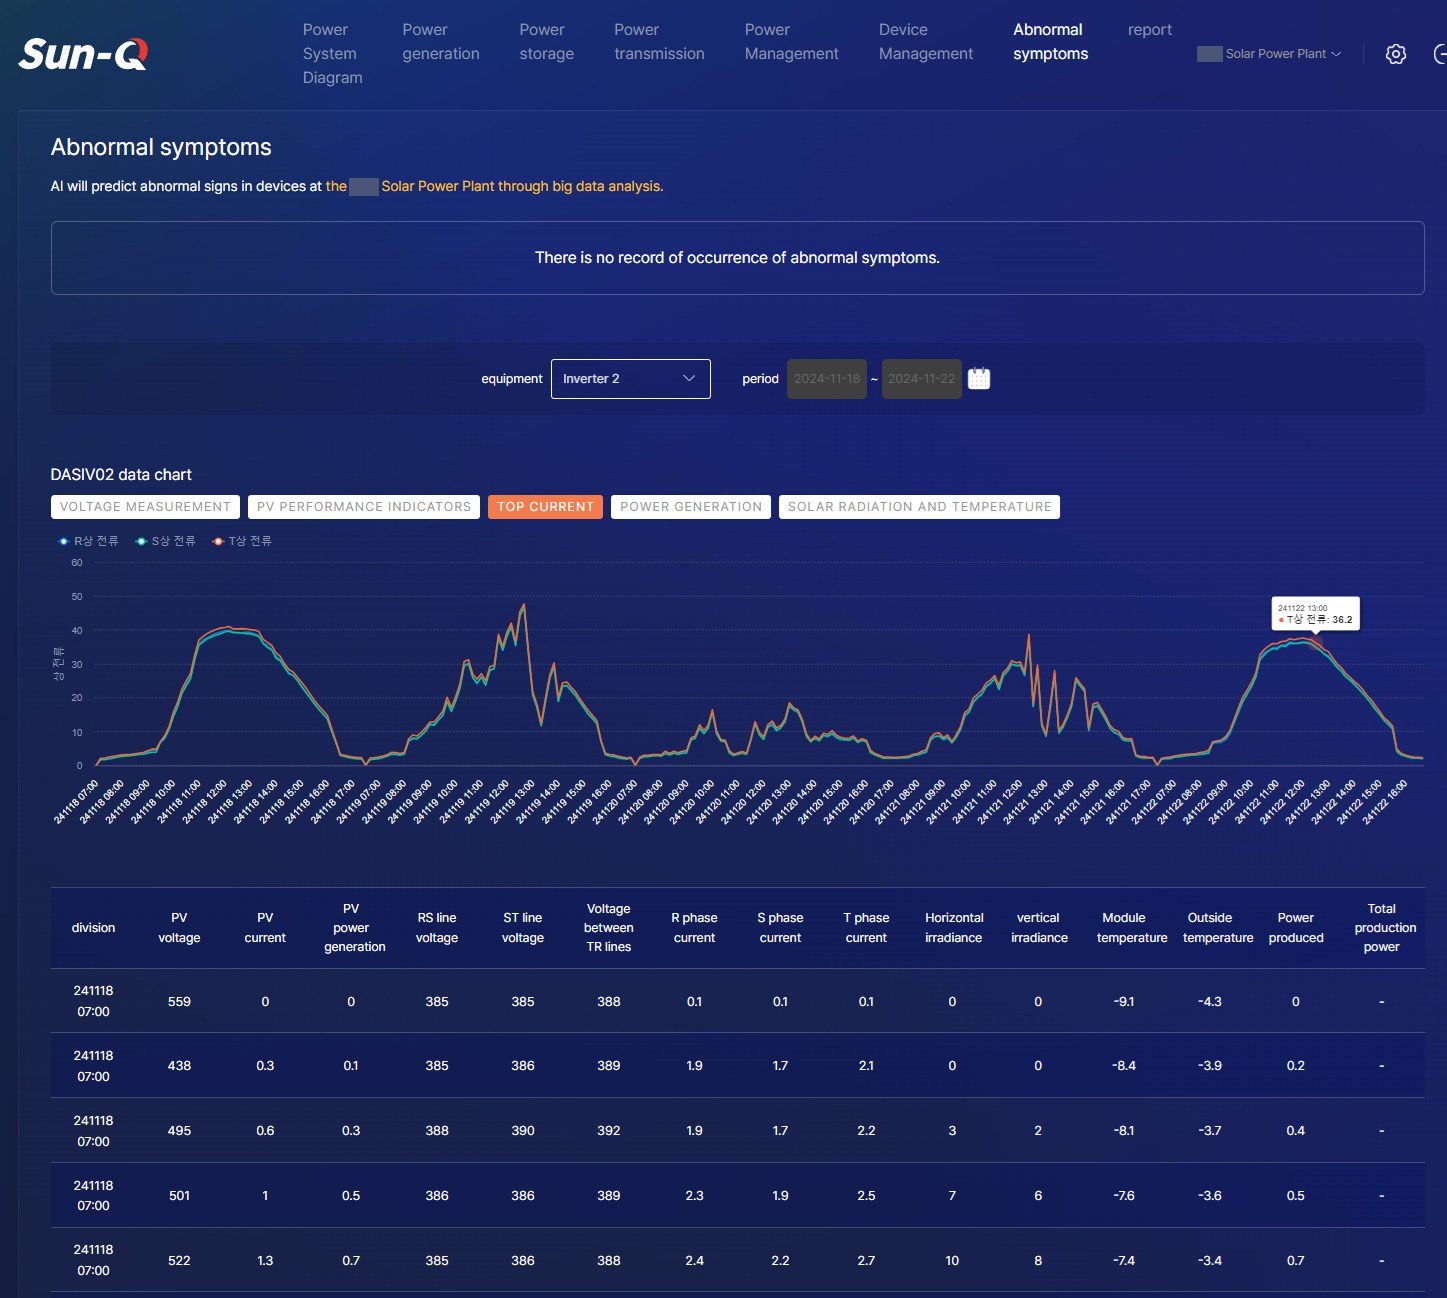
Screenshots des Produktivsystems. Name, Standort und Umsatzzahlen der Anlage sind abgedeckt.
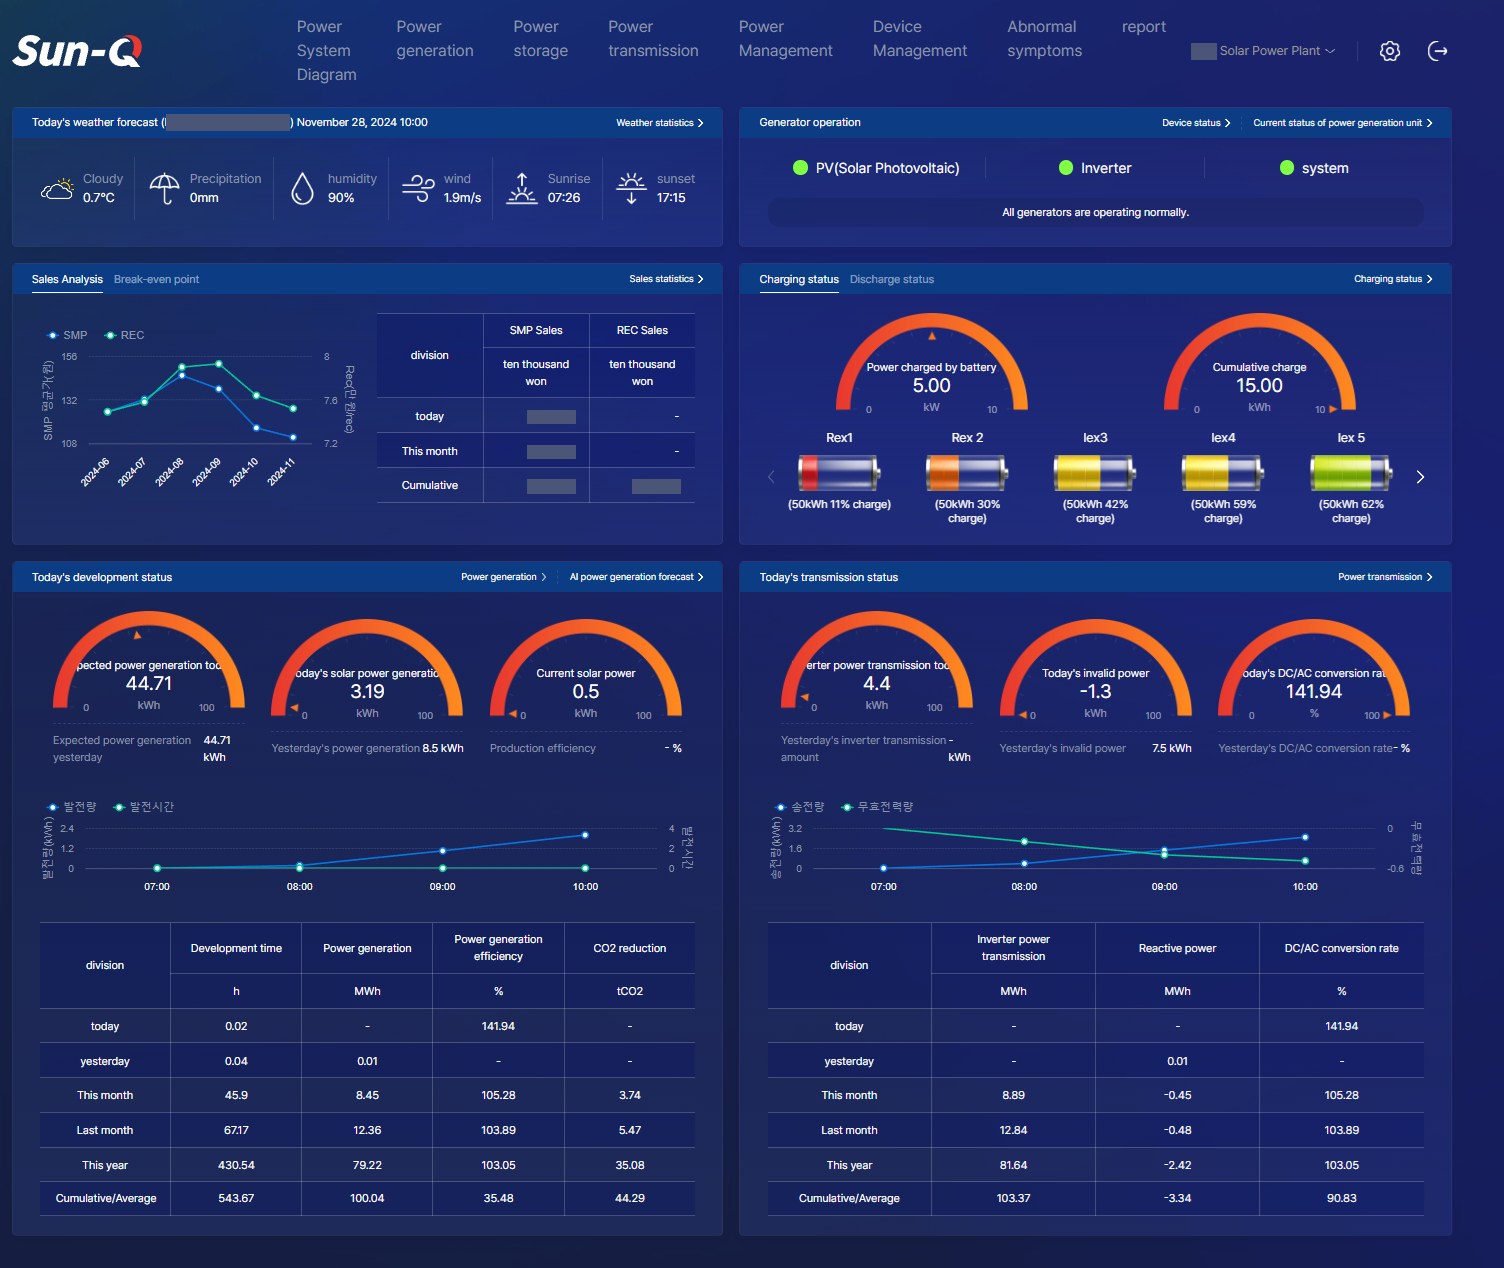
Prognose
- Als AI Engineer habe ich das erste Prognosemodell in PyTorch gebaut. Sein durchschnittlicher Fehler lag unter 10 %, was das Unternehmen für das Geschäft an der KPX qualifizierte.
- Als Team Lead habe ich den Fehler von 9 % auf 7 % gesenkt, indem ich die Daten analysiert und das Modell abgestimmt habe. Das machte Einnahmen aus der Stromvermittlung möglich.
-
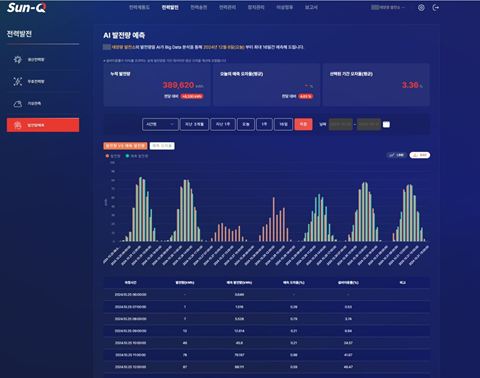 Stündliche Erzeugung und Prognose als Balken
-
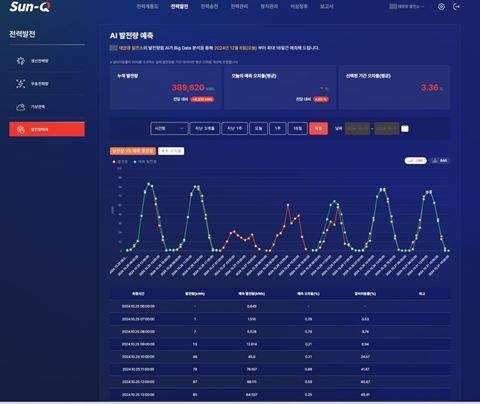 Prognose und tatsächliche Erzeugung in einer weiteren Woche
-
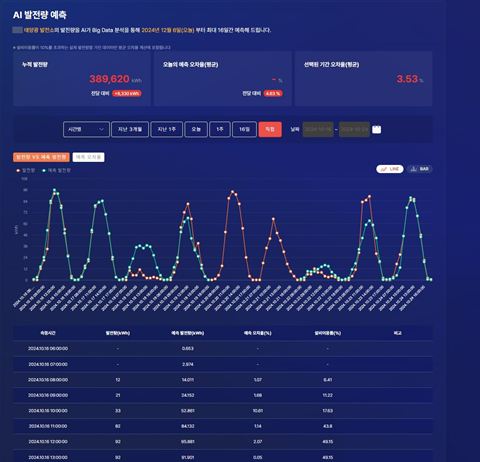 Die Prognoseseite mit einer Fehlertabelle für jede Stunde
Anomalieerkennung für Solarkraftwerke
Der Detektor ist ein Graph Neural Network (GNNAD). Er lernt, wie sich die Messwerte einer Anlage normalerweise gemeinsam verändern, und meldet Messwerte, die aus diesem Muster fallen.
Im Praktikum habe ich seine erste Version abgestimmt, die Experimente in MLflow nachverfolgt und die FastAPI-Endpunkte gebaut, die ihn mit der VPP-Plattform verbinden. Als Team Lead habe ich seine Genauigkeit Schritt für Schritt erhöht und jeden Schritt gemessen:
- Ein klarerer Blick auf Fehler. Ich habe den Open-Source-Code stark überarbeitet und Diagramme ergänzt, die für jedes Feature die Vorhersage mit dem tatsächlichen Messwert vergleichen, damit wir sehen konnten, wo das Modell danebenlag.
- Eine bessere Fehlerberechnung erhöhte die Precision um 5 Prozentpunkte und den Recall um 7.
- Stündliche Schwellenwerte. Ein Schwellenwert für den ganzen Tag übersah zu manchen Stunden Anomalien, weil sich der Fehler im Tagesverlauf ändert. Mit 24 Schwellenwerten, einem pro Stunde, stieg der Recall um 10 Prozentpunkte.
- Sauberere Trainingsdaten. Das Entfernen anomaler Punkte aus dem Trainingsdatensatz erhöhte die Precision um 30 Prozentpunkte und den Recall um 20.
- Ehrliche Validierung. Die Kreuzvalidierung läuft so wie der Produktivbetrieb, mit Inferenzfenstern von 16 Punkten, stündlichen Schwellenwerten und nächtlichem Neutraining, damit ein gutes Testergebnis auch ein gutes Ergebnis in Produktion bedeutet.
Insgesamt stieg die Precision um rund 35 Prozentpunkte und der Recall um rund 37. Im Klartext: Der Detektor schlug viel seltener falschen Alarm und übersah viel seltener echte Probleme.
- Bessere Fehlerberechnung
- Stündliche Schwellenwerte
- Sauberere Trainingsdaten
-
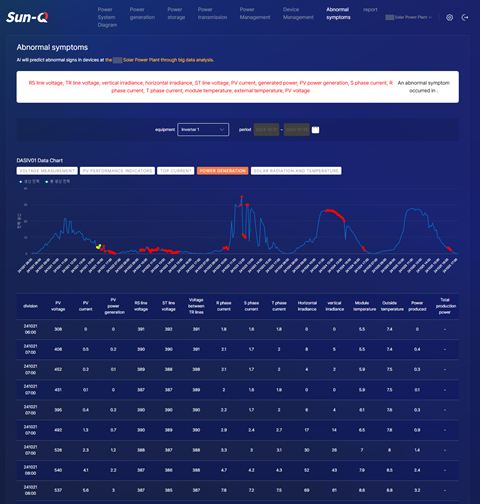 Gefundene Anomalien: Die betroffenen Merkmale werden aufgelistet, die Punkte rot oder gelb markiert
-
 Derselbe Zeitraum im Spannungsdiagramm
-
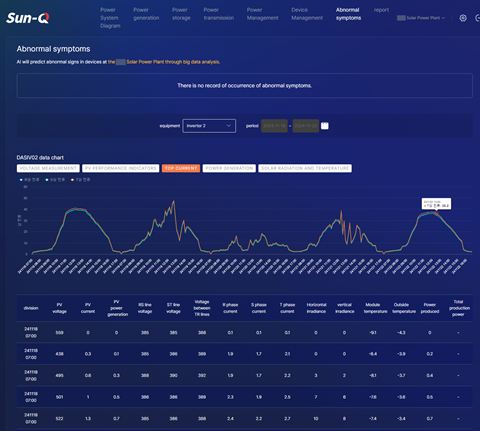 Überwachung ohne gefundene Anomalien
MLOps und Deployment
- Als AI Engineer habe ich den Detektor in Container verpackt und sein Deployment mit GitHub Actions automatisiert. Ein Deployment dauerte 15 Minuten statt 3 Stunden.
- Als Team Lead habe ich die restliche MLOps-Umgebung aufgebaut: Docker-Compose-Dienste mit PostgreSQL, Deployments aus GitHub Actions und Prometheus-Metriken auf Grafana-Dashboards. Der manuelle Betriebsaufwand sank um 80 %, was rund 48.000 $ pro Jahr einsparte.
Deployment-Zeit
Manueller Betriebsaufwand
Teamleitung
Als AI Team Lead habe ich die ML-, Backend- und Frontend-Teams geführt. Meine Aufgabe war es, dafür zu sorgen, dass die Modelle keine Experimente blieben: Sie mussten jeden Tag laufen und sich sauber in die VPP-Plattform einfügen.
Ergebnisse
- 9 % → 7 %Prognosefehler, der Einnahmen aus der Stromvermittlung an der KPX möglich machte
- +35 / +37 PPPrecision / Recall des Detektors
- 3 h → 15 minDeployment-Zeit
- −80 %manueller Betriebsaufwand, rund 48.000 $ pro Jahr
Diese Seite enthält keinen Code des Arbeitgebers, keine internen Daten und keine privaten URLs.