자동차 부품 AI 의미 검색
구매자가 자기 언어로 평범한 설명을 입력하면, 검색이 구매자의 차량에 정확히 맞는 부품을 찾아 줍니다. 벡터 검색, 개체명 인식, 질의를 정제하는 LLM을 결합했고, 자동 정확도 테스트 스위트도 만들었습니다.
정부 R&D 사업의 3,000개 부품 테스트에서 95% 이상을 기록했고, 과제는 승인되었습니다.
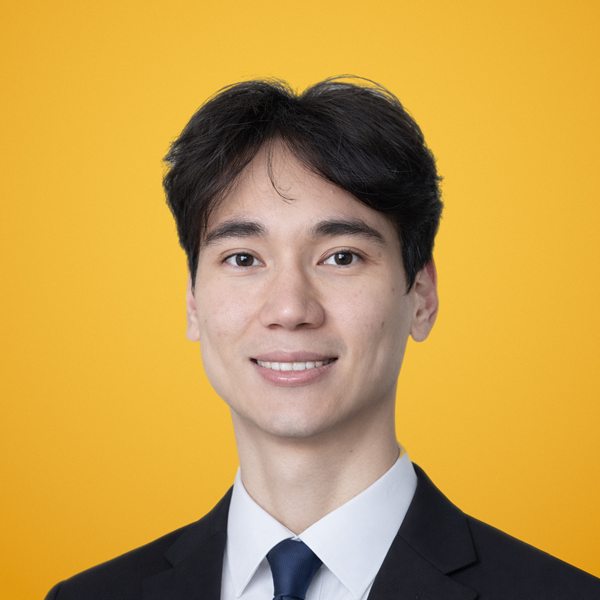
AI/ML 엔지니어
LLM·벡터 검색, AWS 데이터 파이프라인, MLOps까지 실제 서비스에서 운영되는 AI 시스템을 만듭니다.
AI/ML 시스템을 구축하고 운영한 지 2년이 넘었습니다. 최근에는 중고 자동차 부품 온라인 쇼핑몰의 유일한 AI/ML 엔지니어였습니다. 그전에는 재생에너지 기업에서 AI 팀을 이끌었습니다.
대한민국 대전에 살고 있으며, 우선 한국에서 AI/ML 엔지니어 직무를 찾고 있습니다. 이후 독일로 이주할 계획입니다. 독일을 비롯해 스위스, 덴마크 등 유럽의 직무와 원격 근무도 고려하고 있습니다.
주요 프로젝트
제가 일하는 방식을 보여 주는 네 가지 프로젝트입니다. 각 사례는 어떤 문제가 있었는지, 무엇을 만들었는지, 어떻게 측정했는지, 무엇이 달라졌는지를 이야기합니다. 회사 코드와 비공개 데이터는 이 페이지들에 싣지 않았습니다.
구매자가 자기 언어로 평범한 설명을 입력하면, 검색이 구매자의 차량에 정확히 맞는 부품을 찾아 줍니다. 벡터 검색, 개체명 인식, 질의를 정제하는 LLM을 결합했고, 자동 정확도 테스트 스위트도 만들었습니다.
정부 R&D 사업의 3,000개 부품 테스트에서 95% 이상을 기록했고, 과제는 승인되었습니다.
가격 분석에는 시장의 중고 부품 매물을 매일 받아 오는 피드가 필요했습니다. 저는 이벤트 기반 파이프라인을 만들었습니다. 정해진 일정에 따라 Lambda 워커가 SQS 큐에서 작업을 가져와 매물을 PostgreSQL에 저장하고, 무언가 실패하면 CloudWatch가 알람을 보냅니다.
테스트에서는 가장 작은 데이터베이스 인스턴스로 하루 500만 건이라는 목표를 달성했습니다. 프로덕션에서는 데이터 소스의 요청 속도 제한 때문에 하루 약 5,000건에 머물렀습니다.
두 가지 모델을 프로덕션에 올린 팀을 이끌었습니다. 하나는 태양광 발전소가 전력을 얼마나 생산할지 예측하고, 다른 하나는 발전소 데이터에서 평소와 다른 측정값을 찾아냅니다. 두 모델 모두 여러 발전소를 하나처럼 묶어 운영하는 플랫폼인 가상발전소(VPP)에 연동되었습니다.
예측 오차가 9%에서 7%로 떨어져, 한국전력거래소에서 전력을 팔 수 있는 수준이 되었습니다. 이상 탐지 모델의 precision은 35퍼센트포인트(%p), recall은 37%p 올랐습니다. 배포는 3시간 대신 15분이 걸렸습니다.
데이터팀은 외부 카탈로그 데이터를 손으로 적재하고 있었습니다. 저는 브랜드, 모델, 연식, 지역을 받아 그에 맞는 부품 데이터를 가져오고, 정리해서 카탈로그에 써 넣는 에이전트 워크플로를 만들었습니다. 작업은 예약된 일정에 따라 실행되고, 실패한 뒤에도 이어서 진행되며, 팀이 확인할 수 있는 리포트로 끝납니다.
데이터팀을 위한 데모 UI를 갖춘 작동하는 프로토타입입니다. 제가 퇴사할 때는 프로덕션에 적용되지 않은 상태였습니다.
감가상각, 수요, 실시간 시장 신호로 중고 부품의 가격을 매기는 모델을 연구했습니다. 실제 가격으로 이루어진 작은 테스트 세트에서 MAE와 MAPE로 측정한 정확도는 약 70–80%였습니다.
회사의 약 4만 개 상품 하나하나에 영어 요약과 한국어 요약을 써 주는 LLM 파이프라인을 만들었습니다. 요약은 부품 전문가들이 정한 규칙을 따랐습니다. 이 파이프라인은 개념 검증(PoC) 단계에 머물렀습니다.
회사 레코드 약 4만 건을 새 데이터베이스로 옮기고, 외부 카탈로그 레코드 200만 건 이상을 적재했습니다. 중복은 제거했고, 각 배치는 원자적으로 썼기 때문에 실패해도 데이터가 반쯤 쓰인 채로 남을 수 없었습니다.
개발 방식
2026년 4월부터 대부분의 소프트웨어를 코딩 에이전트인 Claude Code와 Codex에게 지시하는 방식으로 만듭니다. 에이전트는 빠릅니다. 그 주변에 제가 둔 규칙, 프로젝트 노트, 검증 절차가 작업의 신뢰성을 지킵니다. 제가 직접 쓰는 두 앱과 누구나 해 볼 수 있는 물리 엔진이 그 결과를 보여 줍니다.
앱이 제 휴대폰에서 은행의 Excel 거래내역을 읽습니다. 코드가 모든 금액과 날짜를 읽고, AI가 카테고리를 하나씩 고르고, 제가 각 행을 확인합니다. 그러면 여자친구는 정산할 금액이 담긴 Telegram 메시지를 받습니다.
이 앱이 매년 40~100시간을 아껴 준다고 추정합니다.
대화 내용을 평범한 말로 적으면, AI 에이전트가 그 내용을 알맞은 사람의 기록에 저장하고 그 사람들에 관한 질문에 답합니다. 에이전트는 제 휴대폰에서 실행되는 도구로만 움직이며, 삭제는 제가 누를 때까지 기다립니다.
한 번 누르면 응답을 되돌릴 수 있고, 틀린 답변은 모두 보고해서 고칠 수 있습니다.
피부, 근육, 뼈가 실제 물리에 따라 타격 하나하나에 반응하며, 브라우저에서 바로 실행됩니다. 저는 물리 수치를 판단할 수 없어서, 각 테스트에 실제로 일어나는 결과와 그 근거가 된 연구를 적어 둡니다.
변경할 때마다, 사이트에 반영하기 전에 각 테스트 스윙을 45가지 조건으로 다시 실행합니다.
규칙과 프로젝트 노트를 한곳에 모아 두고, 19개 프로젝트가 이를 불러옵니다. 회사 프로젝트 9개와 개인 프로젝트 10개입니다. Claude Code와 Codex는 같은 기준을 읽고, 이전 세션의 맥락을 이어받습니다. 규칙을 불러오지 못하는 에이전트는 멈추고 질문해야 합니다.
이 규칙에 따라 에이전트는 변경을 작게 유지하고, 문서를 갱신하며, 비밀 정보를 읽거나 프로덕션 데이터베이스를 건드리지 않습니다. 작업은 실제 엔드투엔드 검증을 통과한 뒤에야 완료로 인정됩니다.
Claude 기반의 작은 서비스로, 제 모든 앱에 하나의 AI 엔드포인트를 제공합니다. OpenAI 형식의 요청을 받기 때문에 기존 클라이언트를 수정 없이 쓸 수 있고, JSON Schema에 맞는 출력을 반환합니다.
에이전트 루프도 실행할 수 있습니다. 모델이 어떤 도구를 호출할지 정하지만, 도구는 호출한 앱이 자기 데이터로 직접 실행하고 그 결과만 돌려보냅니다. 게이트웨이는 앱 데이터를 저장하지 않습니다.
Expenses와 Network App 외에도 에이전트는 OneShot Reminder, Notes, Life Simulator를 만들었습니다. OneShot Reminder도 AI를 사용하며, 할 일을 저장하기 전에 하나하나 제게 확인을 받습니다. 앱들은 서명된 GitHub Releases에서 스스로 업데이트됩니다.
이전 ML 작업으로는 프리랜스 고객을 위해 만든, 당뇨망막병증의 등급을 매기는 이미지 분류 모델과 태양광 예측을 위한 강화학습 실험이 있습니다. 더 많은 작업은 GitHub에서 볼 수 있습니다.
경력
2025년 3월 – 2026년 7월 대한민국 (원격)
G-Man Auto Parts · 중고 자동차 부품 이커머스
2024년 11월 – 2025년 2월 원격
Upwork · 의료 영상 분석
2024년 3월 – 2024년 11월 대한민국 나주
Recs Innovation · 재생에너지
두 차례 승진: Data Science Intern → AI Engineer → AI Team Lead
기술
학력 & 자격
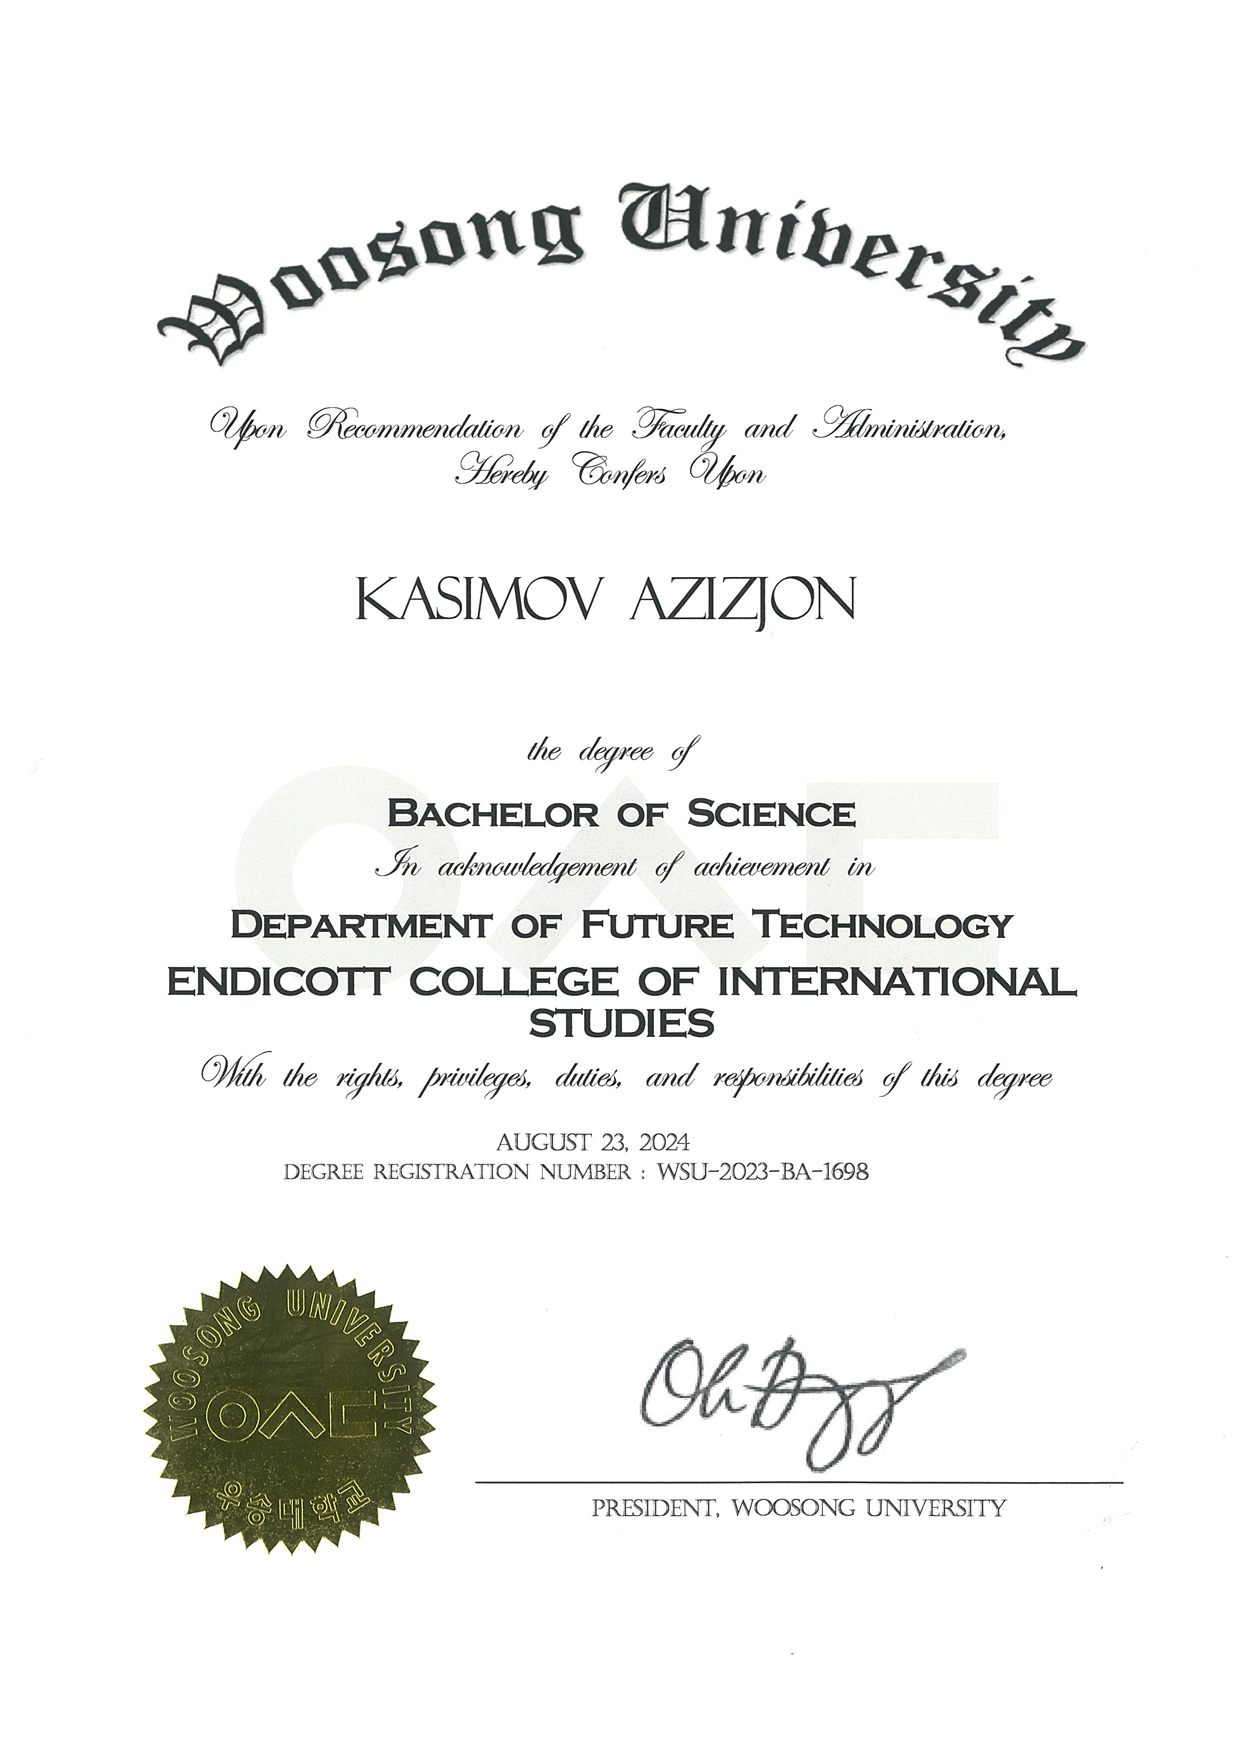
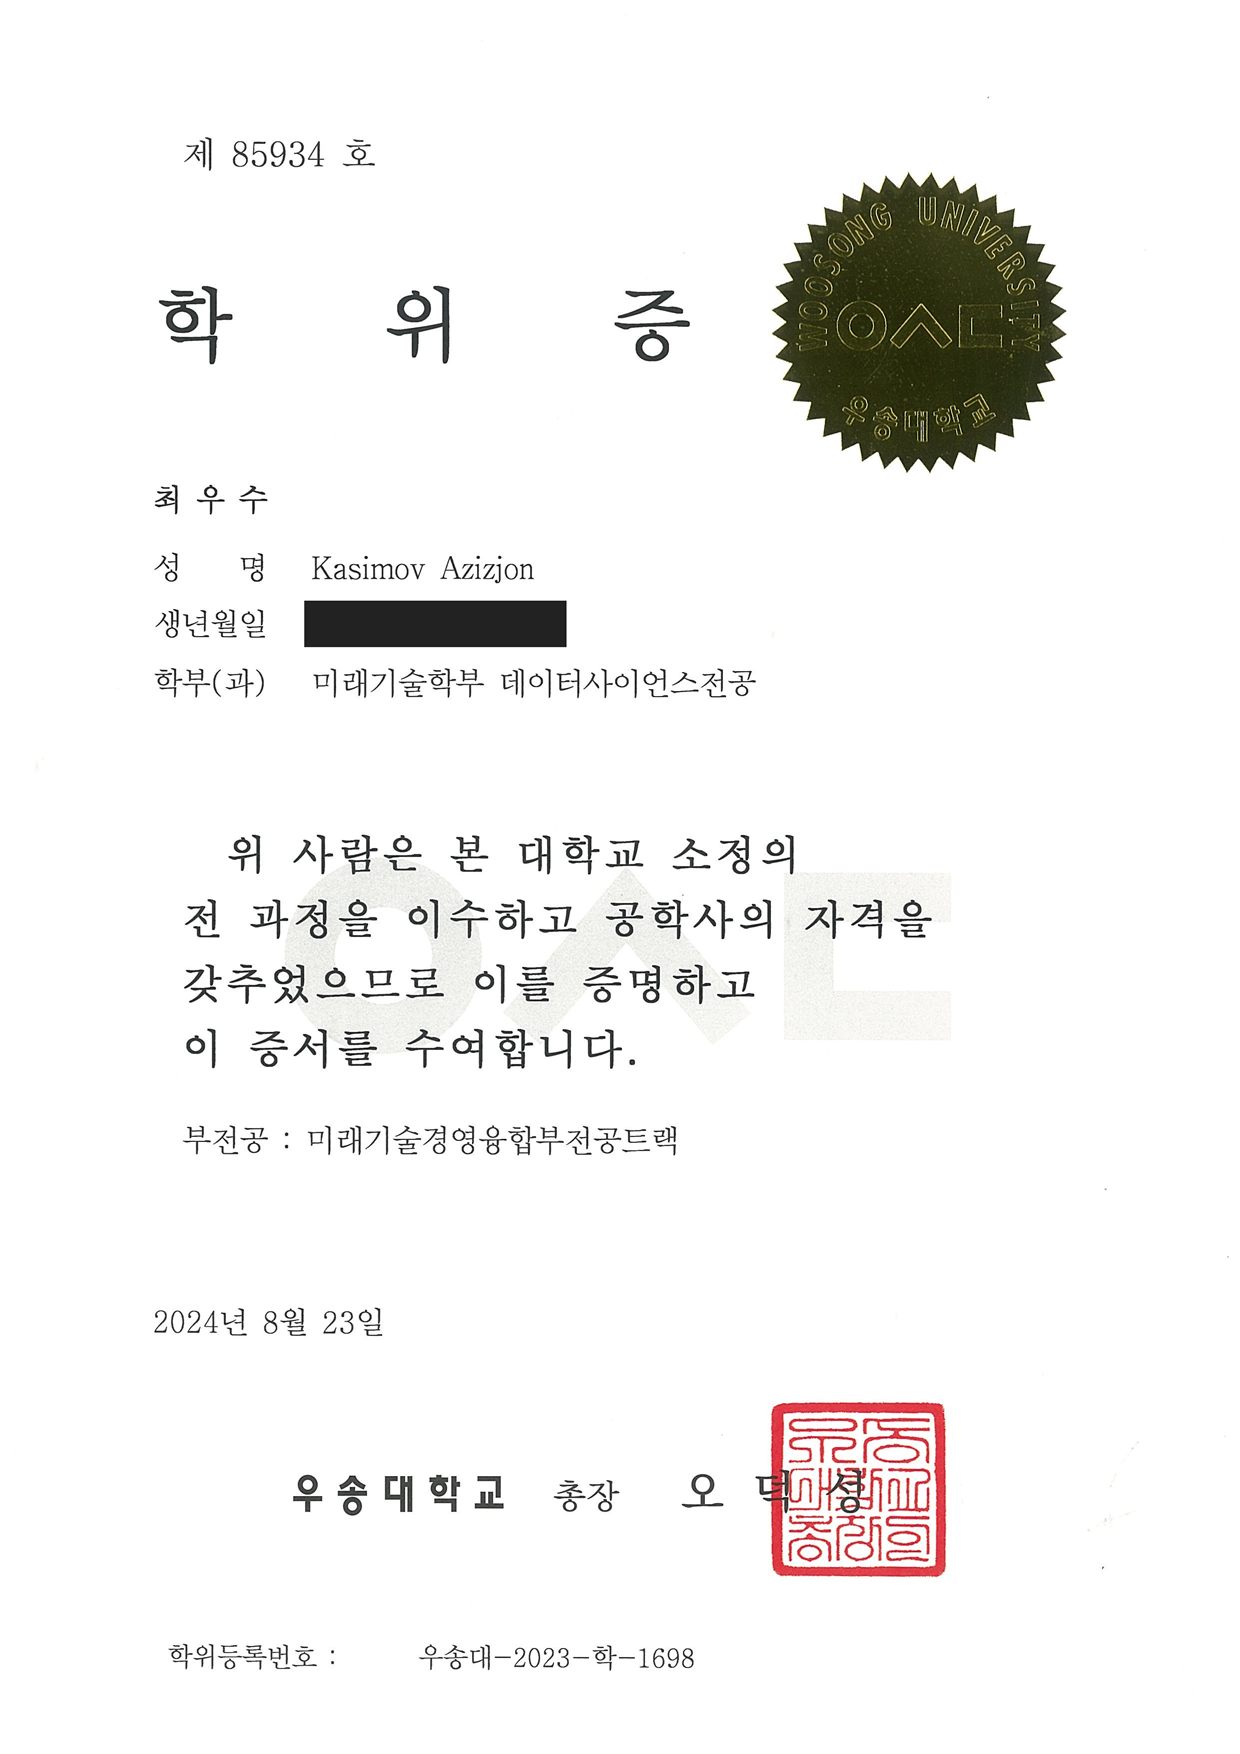
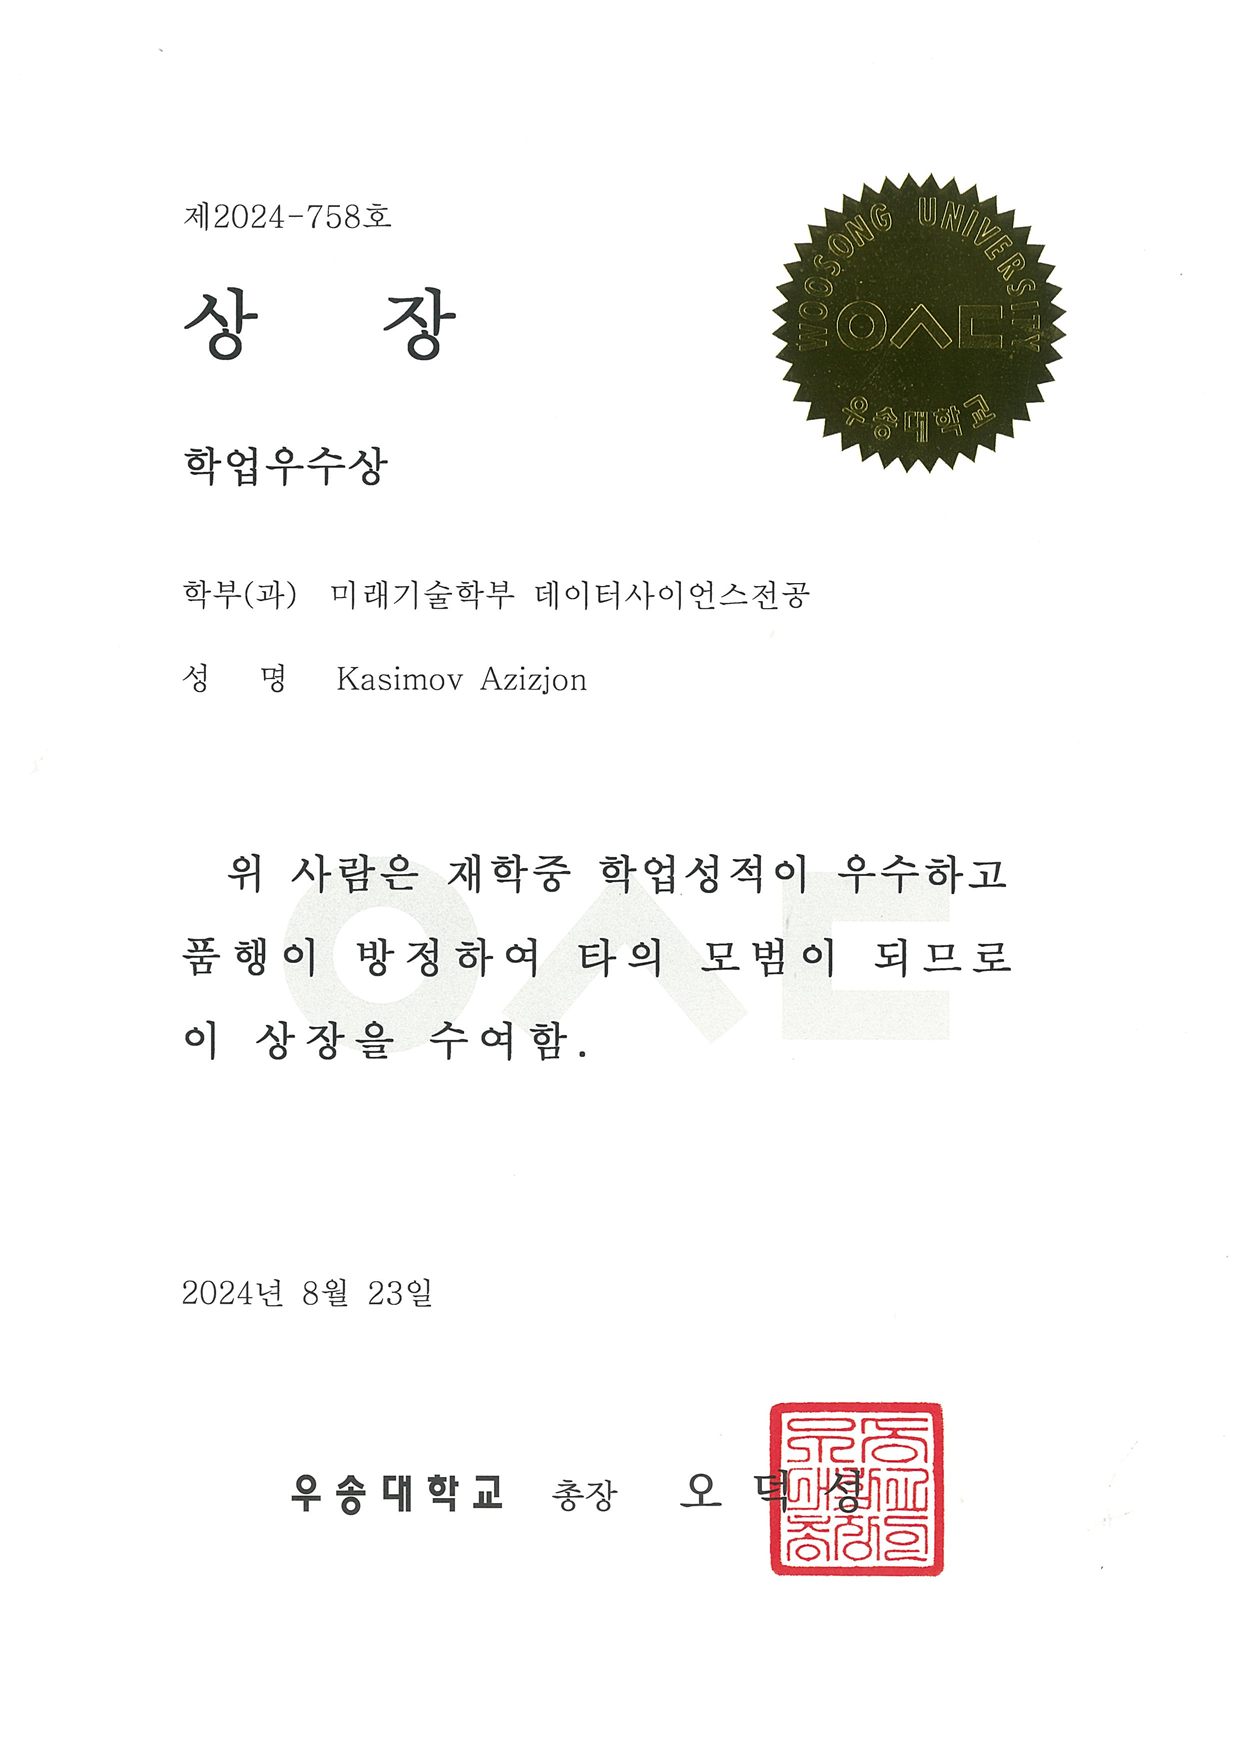
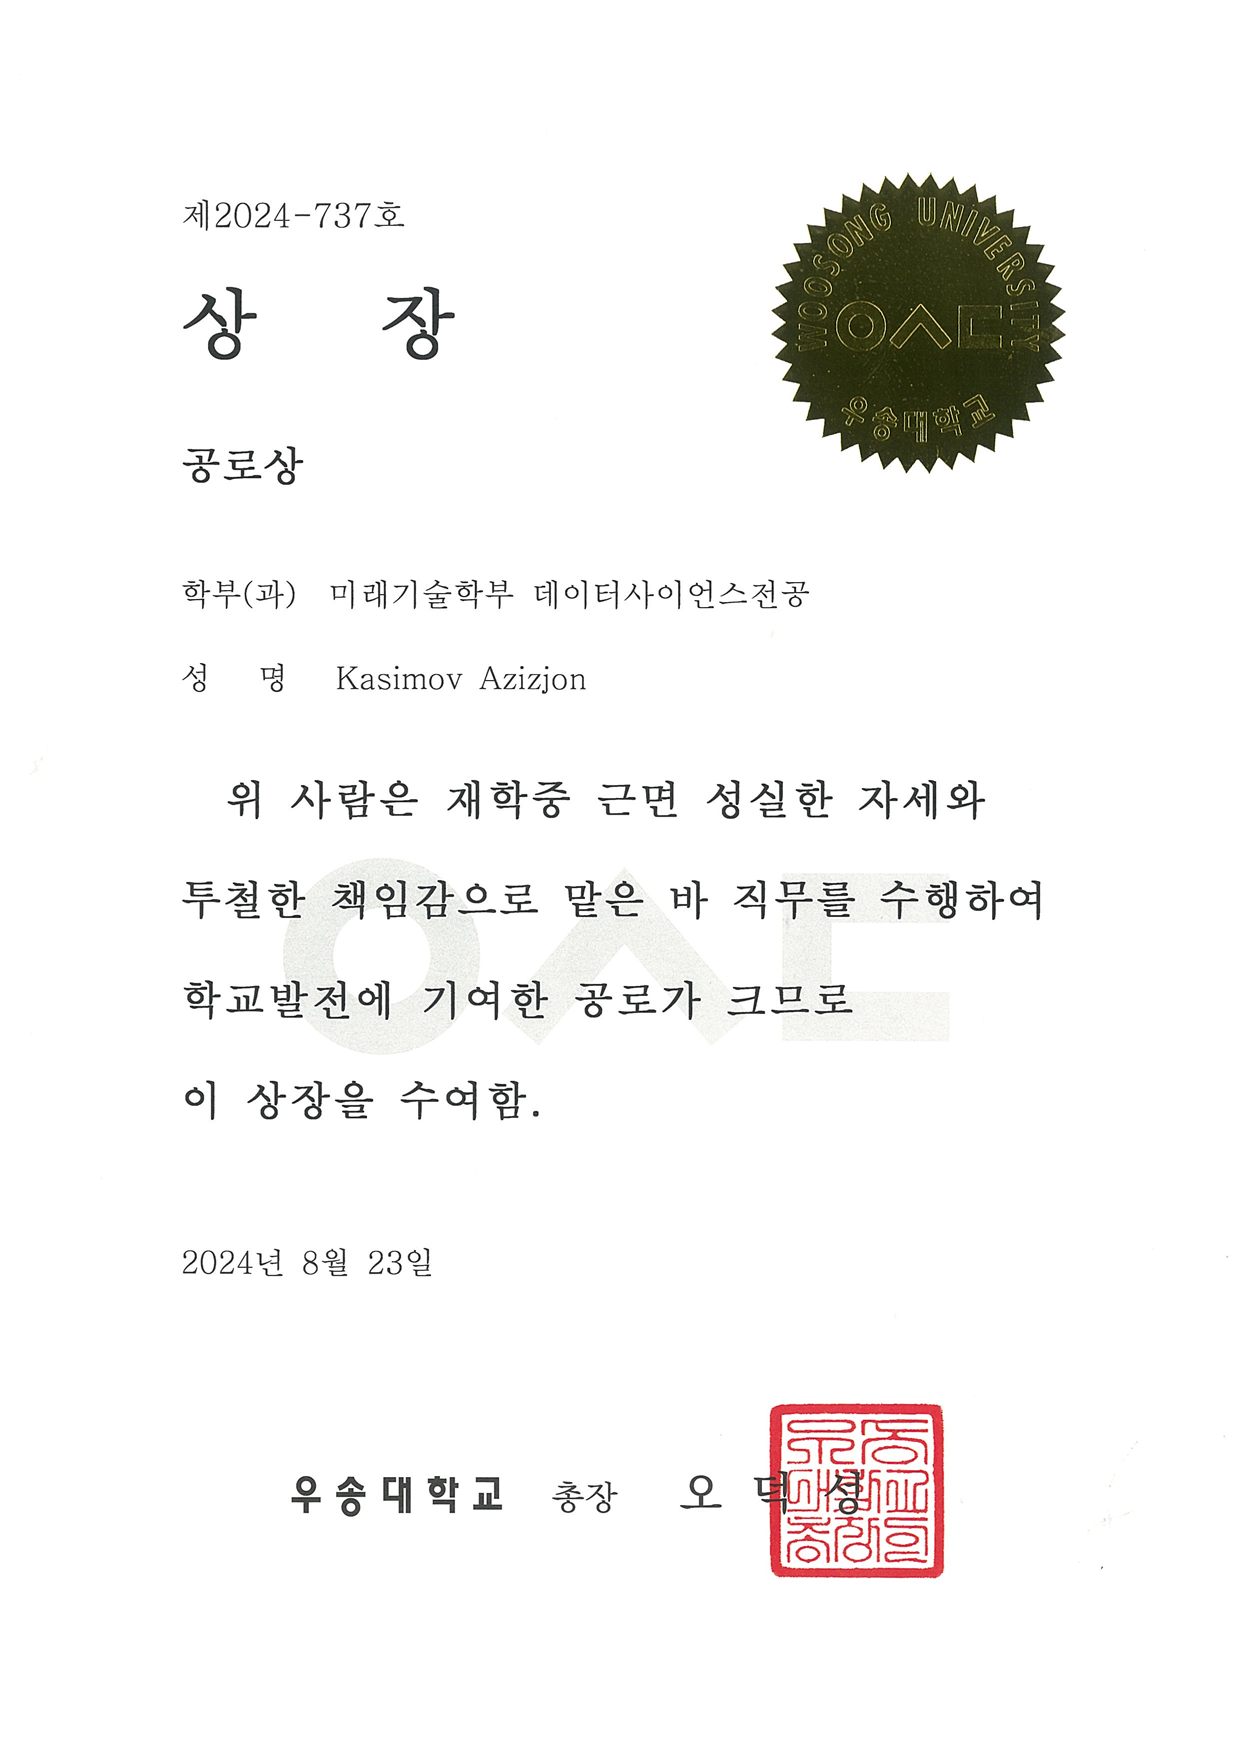
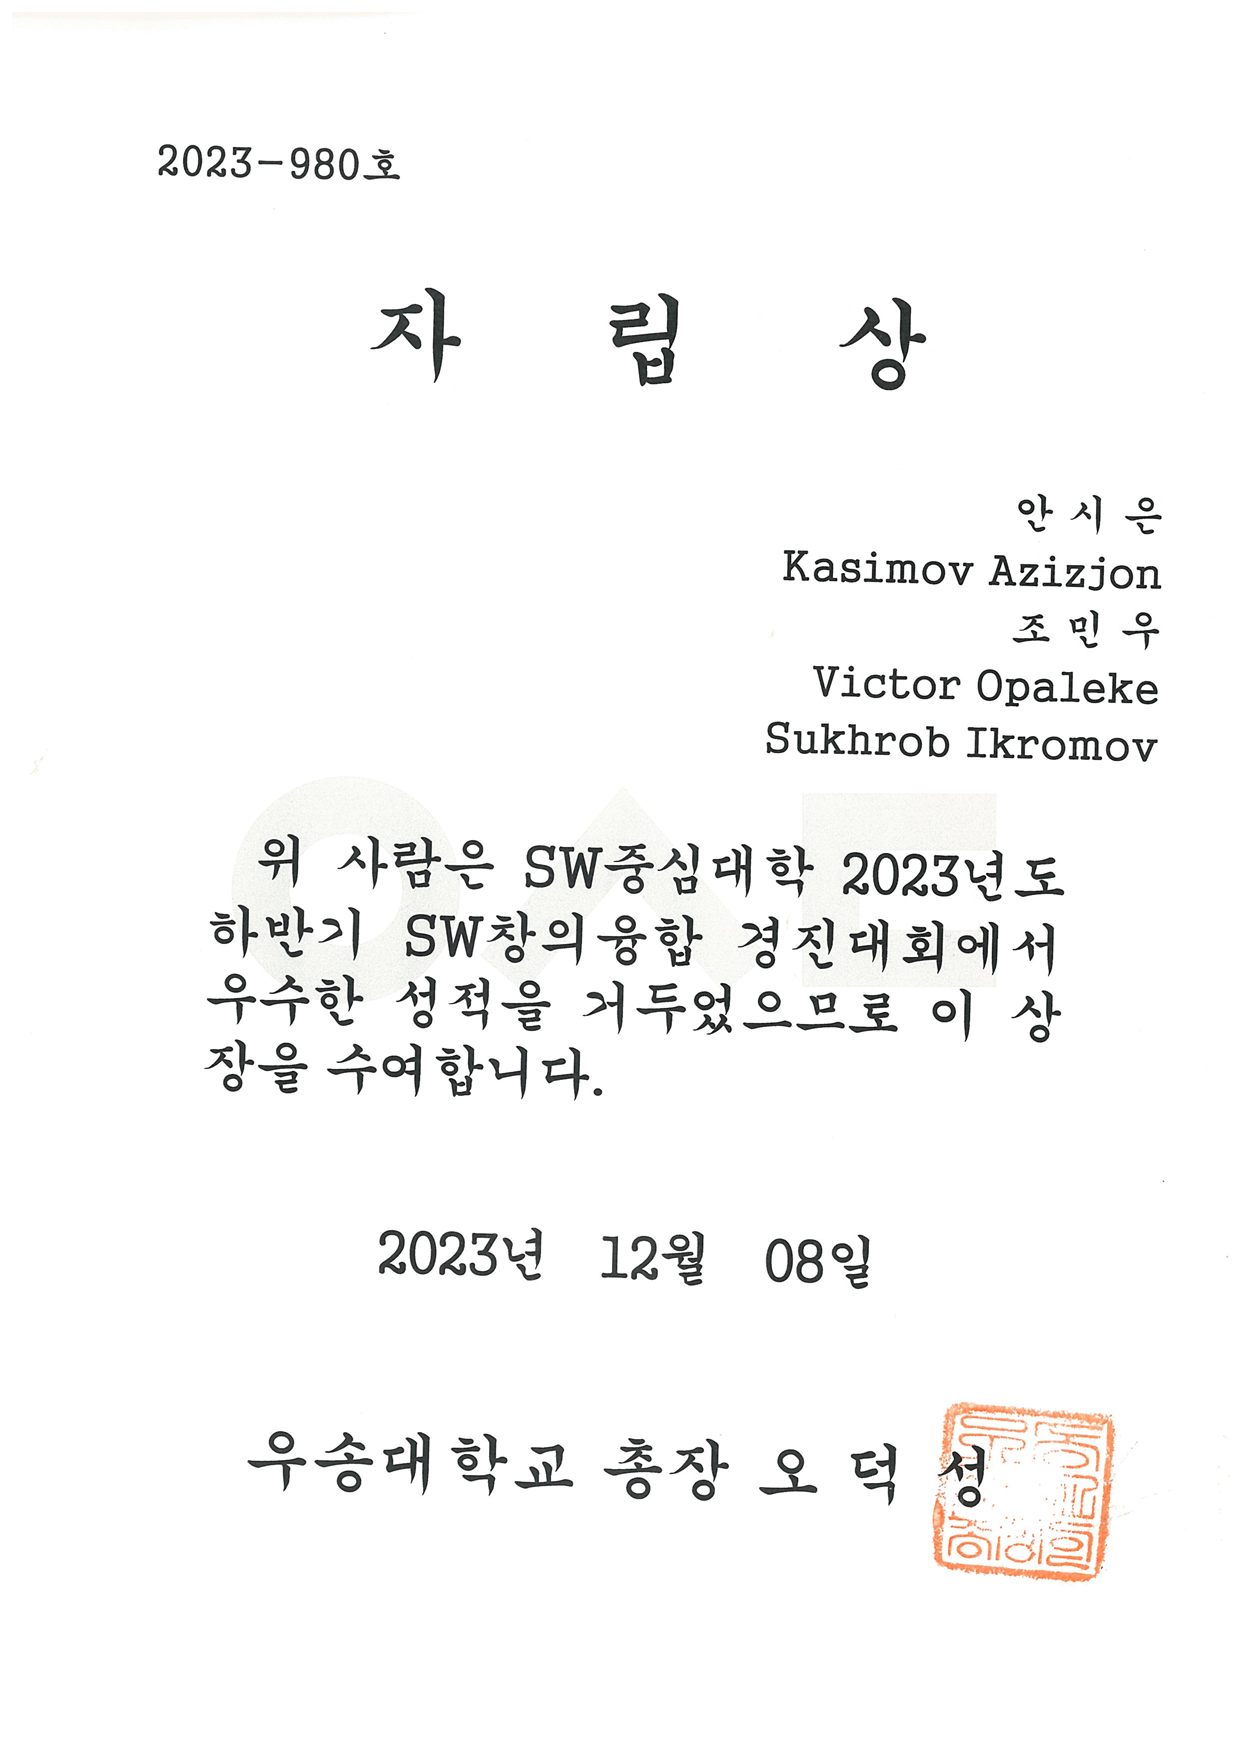
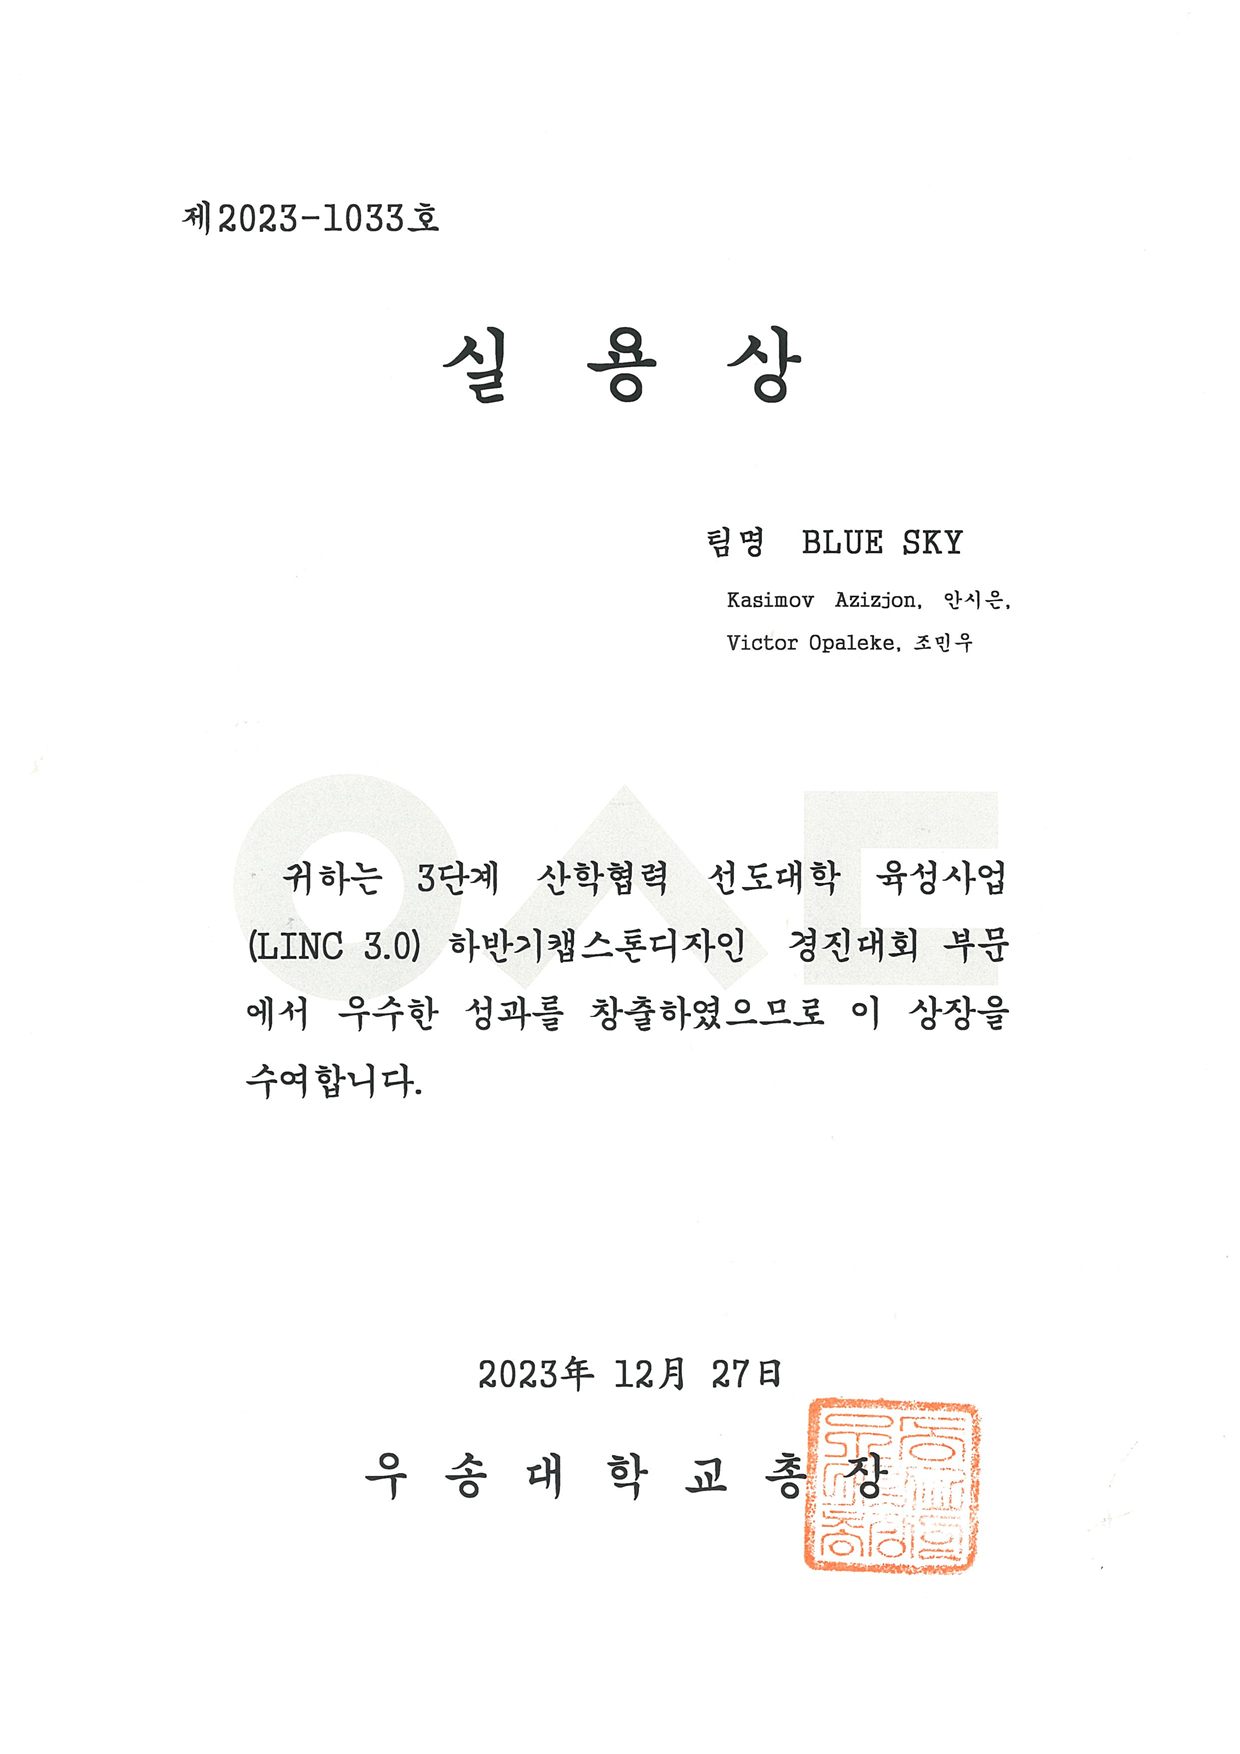
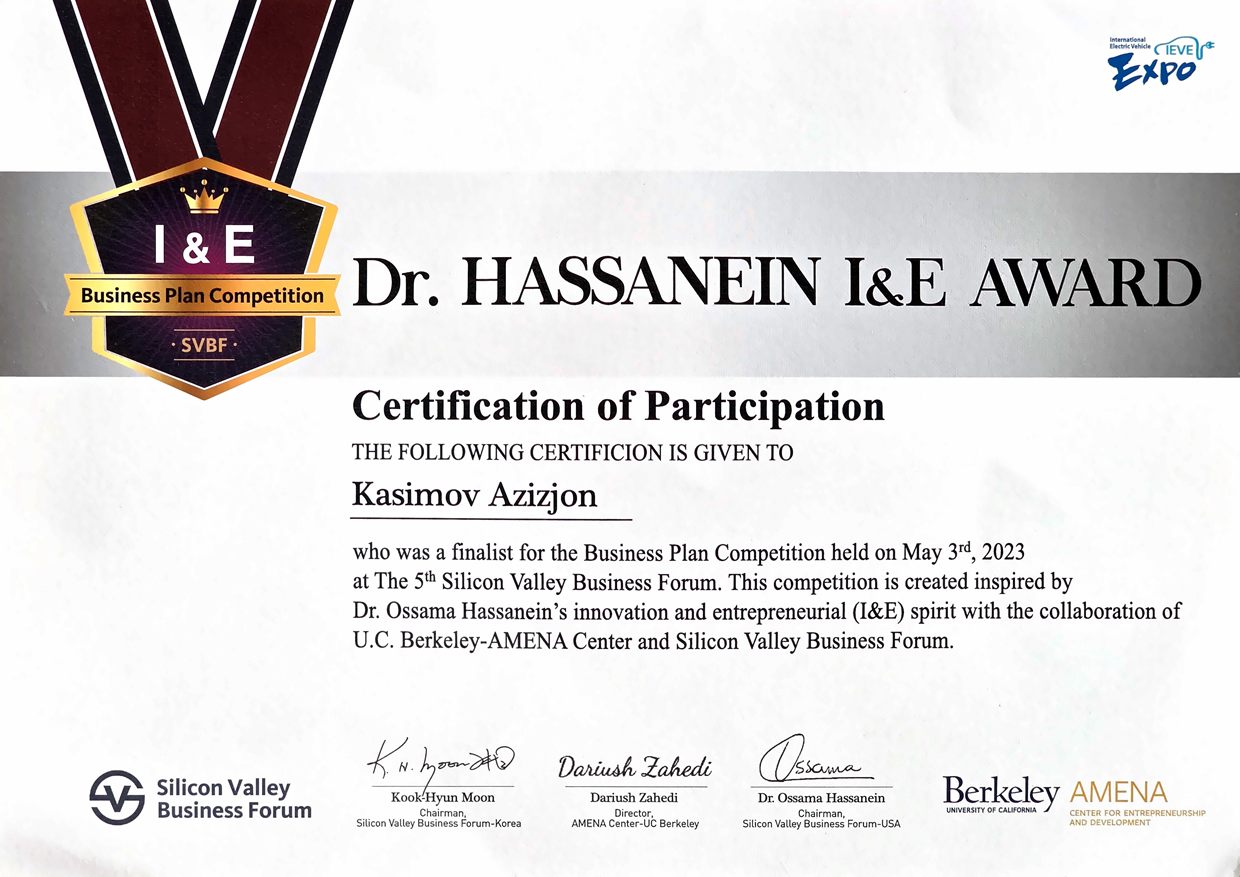
작은 이미지는 학위증과 상장을 스캔한 것이며, 생년월일은 가렸습니다. 누르면 크게 볼 수 있습니다.
연락처
LLM·검색 시스템, MLOps, AI 백엔드, 데이터 플랫폼 분야의 AI/ML 엔지니어 직무를 찾고 있습니다. 이메일이 가장 빠른 연락 방법입니다.